
Odakle LLM dobija svoje podatke? RAG izvori podataka u Python-u
Prethodni članak, Šta je RAG? Najjednostavnije objašnjenje kako funkcioniše, uspostavio je mentalni model: LLM piše, RAG pronalazi korisno znanje, aplikacija poseduje trenutno stanje, a alati izvršavaju radnje. Ovaj članak čini sledeći korak: odakle podaci zapravo dolaze i kako pretraga izgleda u Python-u?
Važno iznenađenje je da „izvor podataka za LLM“ obično nije ništa egzotično. To može biti tekstualni fajl, fascikla sa Markdown dokumentima, SQL baza podataka, odgovor API-ja, katalog proizvoda, sistem za podršku ili vektorski indeks izveden iz tih izvora. AI ne poznaje te sisteme magično. Vaša aplikacija mora da učita, upita, pretraži ili pronađe relevantne podatke i smesti rezultat u kontekst modela.
Izvor podataka = gde informacije žive. Pretraga = kako aplikacija pronalazi korisne informacije. Kontekst = izabrane informacije date modelu. LLM = komponenta koja tumači taj kontekst i generiše odgovor.— Model od četiri dela koji se koristi u ovom članku
Pitanje
Kako LLM koristi eksterne podatke kao što su fajlovi, baze podataka ili API-ji, i kako mali Python program može da implementira osnovne RAG korake bez skrivanja iza okvira?
Šta to zapravo znači
Kada programeri kažu da je LLM „povezan sa podacima kompanije“, nekoliko različitih operacija može biti skriveno iza te rečenice. Jedna aplikacija može izvršavati SQL. Druga može pozivati API. Treća može pokretati pretragu punog teksta. Četvrta može izračunavati sličnost ugrađivanja nad delovima dokumenata. Sve one mogu pružiti eksterne informacije LLM-u, ali nisu ista metoda pretrage i ne treba ih tretirati kao međusobno zamenljive.
Ova razlika je važna jer najbolja metoda pretrage zavisi od oblika pitanja. „Koja je naša politika povraćaja?“ je problem pretrage dokumenata. „Koji je trenutni status porudžbine 4711?“ je obično strukturirano pretraživanje baze podataka. „Koji pasus govori o oporavku naloga?“ može biti pretraga po ključnim rečima ili semantička pretraga. RAG je najkorisniji kada sistem mora da otkrije relevantno znanje pre generisanja.
Najjednostavniji primer
Počnite sa tri stringa u običnom Python-u. Nema vektorske baze podataka, nema okvira, a još nema ni LLM-a. Želimo samo da učinimo korak pretrage vidljivim.
documents = [
    "The AKM uses 7.62 mm ammunition.",
    "A Med Kit restores health.",
    "A 4x scope can be attached to several compatible weapons."
]

question = "Which ammunition does the AKM use?"

for document in documents:
    if "AKM" in document:
        print(document)
Program štampa prvu rečenicu jer sadrži termin koji smo tražili. Ovo je primitivna pretraga, ali arhitektura je već vidljiva: pitanje → pretraga → relevantan tekst. RAG dodaje još jedan važan korak: prosledite pronađeni tekst jezičkom modelu zajedno sa pitanjem.
Malo opštija verzija rangira dokumente prema preklapanju termina upita:
import re

documents = [
    {"id": "weapon-akm", "text": "The AKM uses 7.62 mm ammunition."},
    {"id": "healing-medkit", "text": "A Med Kit restores health."},
    {"id": "scope-4x", "text": "A 4x scope can be attached to several compatible weapons."},
]

def words(text):
    return set(re.findall(r"[a-zA-Z0-9.]+", text.lower()))

def retrieve(question, documents, top_k=2):
    query_terms = words(question)
    ranked = []

    for document in documents:
        score = len(query_terms & words(document["text"]))
        if score > 0:
            ranked.append((score, document))

    ranked.sort(key=lambda item: item[0], reverse=True)
    return [document for _, document in ranked[:top_k]]

question = "Which ammunition does the AKM use?"
hits = retrieve(question, documents)

for hit in hits:
    print(hit["id"], "->", hit["text"])
Ovo nije produkcioni pretraživač. Zanemaruje morfologiju, sinonime, pravopisne varijante, dužinu dokumenta i mnoge signale rangiranja. Njegova vrednost je edukativna: RAG ne počinje vektorskom bazom podataka. Počinje pretragom.
Gde primer prestaje da funkcioniše
Tačno ili leksičko podudaranje postaje slabo kada pitanje i izvor koriste različite reči. Dokument može da kaže „održavanje vozila“, dok korisnik pita „kako da popravim svoj auto?“ Leksički pretraživač može da propusti vezu iako je čovek odmah vidi. Semantička pretraga se bavi ovim tako što predstavlja tekst kao vektore i poredi značenje, a ne samo tačne tokene.
Dugački fajlovi stvaraju još jedan problem. Pretraga celog priručnika od 80 stranica kao jedne celine je previše gruba, ali deljenje svake rečenice može uništiti koristan kontekst. Pravi RAG sistemi stoga zahtevaju odluke o parsiranju, deljenju na delove, metapodacima, rangiranju, svežini, dozvolama i poreklu.
Primer takođe ne govori ništa o strukturisanim aktuelnim činjenicama. Ako korisnik pita za trenutni status porudžbine 4711 i aplikacija već ima ključ baze podataka, semantička pretraga je obično pogrešan prvi alat. Deterministički upit baze podataka je bolji.
Direktan odgovor
LLM izvor podataka je svaki eksterni sistem iz kojeg aplikacija može da dobije informacije za model: fajlovi, baze podataka, API-ji, indeksi pretrage, vektorski skladišta ili stanje aplikacije uživo. RAG je obrazac preuzimanja relevantnog znanja iz takvih izvora pre generisanja.
U Python-u, suštinski pipeline može biti veoma mali: učitaj podatke → kreiraj jedinice za preuzimanje → pronađi relevantne dokaze → sastavi kontekst → pozovi LLM. Metoda preuzimanja treba da odgovara izvoru i pitanju. Koristite SQL za tačne strukturisane činjenice, punotekstualnu pretragu za leksičko poklapanje, embedding-e za semantičku sličnost i hibridno preuzimanje kada je nekoliko signala vredno.
Zašto je to tako
Jezički model ne prima automatski sadržaj vašeg fajl sistema, PostgreSQL baze podataka, CRM-a, privatnog API-ja ili novoizmenjenog dokumenta. Aplikacija odlučuje koje eksterne informacije su dostupne i šta se stavlja u trenutni kontekst modela.
Originalni rad Retrieval-Augmented Generation od Lewis et al. kombinovao je generativni model sa eksternom neparametarskom memorijom preuzetom iz gustog vektorskog indeksa. Šira arhitektonska ideja nadživljava tu specifičnu implementaciju: eksterni dokazi mogu se preuzeti u vreme inferencije umesto da se očekuje da sve korisno znanje bude kodirano u parametrima modela.
Ovo stvara korisnu podelu odgovornosti: izvor čuva informacije, pretraživač bira dokaze, kontekst nosi te dokaze u zahtev, a model ih interpretira. Održavanje tih granica vidljivim čini kvarove mnogo lakšim za dijagnostikovanje.
Kontekst: Glavni tipovi izvora podataka
| Izvor | Tipična metoda preuzimanja | Dobro za |
|---|---|---|
| TXT / Markdown / HTML | Parsiranje + leksička ili semantička pretraga | Dokumentacija, priručnici, članci, beleške |
| PDF / DOCX | Ekstrakcija svesna strukture + pretraga | Politike, izveštaji, ugovori, priručnici |
| SQL baza podataka | SQL upit ili filtrirano preuzimanje | Porudžbine, korisnici, proizvodi, strukturisani zapisi |
| REST / GraphQL API | HTTP zahtev sa parametrima | Udaljeni sistemi i podaci servisa uživo |
| Indeks pretrage | BM25 / punotekstualna / hibridna pretraga | Velike tekstualne kolekcije |
| Vektorski indeks | Sličnost embedding-a | Semantičko preuzimanje dokumenata |
| Stanje aplikacije | Direktno čitanje stanja ili poziv alata | Šta je istinito upravo sada |
Vektorski indeks zaslužuje posebnu pažnju. U mnogim arhitekturama on nije kanonski izvor istine. To je indeks za preuzimanje izveden iz dokumenata ili zapisa. Autoritativni dokument može živeti u objektnom skladištu, CMS-u, Git-u, PostgreSQL-u ili drugom sistemu, dok se embedding-i i metapodaci čuvaju odvojeno za brzu semantičku pretragu. Neki sistemi koriste vektorsko skladište kao primarno skladište, ali to je arhitektonski izbor, a ne zahtev RAG-a.
Ako je granica između preuzimanja, trajne memorije, trenutnog stanja i konteksta modela još uvek nejasna, pogledajte AI Agent Memory Is Not RAG. Ti slojevi mogu koristiti neke od istih tehnologija skladištenja, a ipak imati različita pravila ispravnosti.
Pretpostavke
- Aplikaciji je dozvoljen pristup eksternom izvoru.
- Relevantni izvor sadrži dovoljno informacija da odgovori na pitanje.
- Podaci se mogu parsirati ili upitati u obliku koji sloj za preuzimanje može koristiti.
- Preuzete informacije su dovoljno sveže za traženu odluku.
- Model prima izabrane dokaze u svom kontekstu.
- Autorizacija se sprovodi pre nego što zaštićeni dokazi stignu do modela.
- Generativni model i dalje može biti pogrešan čak i kada je preuzimanje ispravno.
Ove pretpostavke su važne jer preuzimanje ne može nadoknaditi nedostajuće dokaze, zastarele verzije izvora, pokvarene parsere ili neovlašćen pristup. RAG pipeline može biti samo onoliko pouzdan koliko je put dokaza koji ga hrani.
Promenljive
| Promenljiva | Zašto menja dizajn |
|---|---|
| Struktura izvora | SQL tabela, pravni PDF i repozitorijum izvornog koda zahtevaju različite strategije preuzimanja |
| Tip pitanja | Tačno pretraživanje, konceptualna pretraga i višekoračno istraživanje su različiti zadaci |
| Zahtev za svežinom | Stanje uživo može zahtevati direktne upite umesto periodično obnavljanih indeksa |
| Veličina korpusa | Pretraga u memoriji može raditi za stotine delova, ali ne za veoma velike kolekcije |
| Jezik | Višejezično preuzimanje zahteva modele i tokenizaciju prikladne za stvarne jezike |
| Dozvole | Preuzimanje mora filtrirati prema pravima pristupa trenutnog korisnika |
| Latencija i trošak | Više faza preuzimanja može poboljšati kvalitet, ali dodaje vreme izvršavanja i troškove infrastrukture |
| Potreba za poreklom | Sistemi visokog poverenja zahtevaju ID-ove izvora, verzije i dokaze koji se mogu pratiti |
Dijagnostička / Metoda odlučivanja
Prva odluka nije „Koju vektorsku bazu podataka treba da instaliram?“ Već: Koju vrstu činjenice pokušavam da pronađem?
| Tip pitanja | Preferirani prvi pristup | Razlog |
|---|---|---|
| Tačan ID ili trenutni zapis | SQL / pretraga po ključu / API | Deterministički strukturirani pristup |
| Tačan tekst, kodovi, nazivi | Pretraga punog teksta ili ključnih reči | Leksička preciznost |
| Konceptualno pitanje o dokumentima | Semantička vektorska pretraga | Značenje se može razlikovati od teksta |
| Mešovito poslovno znanje | Hibridna pretraga + metapodaci filteri | Kombinuje leksičke i semantičke signale |
| Trenutno stanje aplikacije | Direktan pristup stanju/alatu | Svežina je važnija od sličnosti dokumenata |
Koristan test je: Da li već znam koji zapis mi je potreban, ili sistem mora da otkrije koji je odlomak relevantan? Ako je zapis poznat, upitajte ga direktno. Ako relevantnost mora da se otkrije, pretraga postaje važnija.
Kada je odgovor pogrešan, dijagnostikujte pipeline po redu umesto da odmah menjate LLM:
- 1. Pokrivenost izvora: Da li tačna informacija postoji u dostupnom skupu izvora?
- 2. Svežina: Da li je ta verzija dovoljno aktuelna za pitanje?
- 3. Parsiranje: Da li je relevantan sadržaj ispravno izvučen?
- 4. Deljenje na delove: Da li su dokazi ostali zajedno sa uslovima koji im daju značenje?
- 5. Pretraga: Da li se ispravan deo pojavljuje među kandidatima?
- 6. Rangiranje: Da li su jači izvori rangirani iznad slabijih ili konfliktnih?
- 7. Sastavljanje konteksta: Da li je aplikacija zaista poslala izabrane dokaze modelu?
- 8. Generisanje: Da li je LLM verno koristio priložene dokaze?
- 9. Pripisivanje: Može li svaka važna tvrdnja da se prati do izvora?
Za dublju metodu otklanjanja grešaka u produkciji, pogledajte RAG nije uspeo — ali koji sloj je zapravo zakazao? Dijagnostička metoda, koja proširuje ovaj lanac na nezavisno testabilne slojeve otkaza.
Dokazi
RAG rad Lewisa i saradnika formalizovao je generisanje koje se uslovljava na preuzetu eksternu memoriju umesto da se oslanja samo na parametre modela. To pruža konceptualni temelj za razdvajanje generatora od izvora znanja koji se može preuzeti.
Sentence Transformers dokumentuje semantičku pretragu kao ugrađivanje korpusa i upita u vektorski prostor i preuzimanje stavki sa visokom semantičkom sličnošću. Njegov trenutni API takođe razlikuje kodiranje upita od kodiranja dokumenata za zadatke preuzimanja.
SQLite FTS5 demonstrira drugu stranu spektra: zrelo preuzimanje punog teksta može rangirati dokumente bez ugrađivanja. To je važno jer leksička pretraga ostaje vredna za identifikatore, tačnu terminologiju i mnoge hibridne dizajne preuzimanja.
OpenAI dokumentacija o ugrađivanjima opisuje ugrađivanja kao numeričke vektorske reprezentacije koje se koriste za povezanost i pretragu. To je jedan put implementacije za semantičko preuzimanje, a ne definicija samog RAG-a.
Stvarni primer 1: Fascikla sa tekstualnim datotekama
Pretpostavimo da direktorijum pod nazivom knowledge/ sadrži obične tekstualne datoteke. Python ih može učitati bez ikakve AI biblioteke.
from pathlib import Path

def load_text_files(folder="knowledge"):
    documents = []

    for path in Path(folder).glob("*.txt"):
        documents.append({
            "source": path.name,
            "text": path.read_text(encoding="utf-8")
        })

    return documents

documents = load_text_files()

for document in documents:
    print(document["source"], len(document["text"]))
Fajl sistem je izvor podataka. Sledeće pitanje je koliko teksta treba da postane jedna jedinica koja se može preuzeti. Za duge dokumente, pretraga jednog kompletnog fajla je često previše gruba. Zato RAG pipeline-ovi obično kreiraju delove.
Vrlo jednostavan alat za deljenje na delove
def chunk_text(text, max_chars=800):
    paragraphs = [p.strip() for p in text.split("\n\n") if p.strip()]

    chunks = []
    current = ""

    for paragraph in paragraphs:
        candidate = f"{current}\n\n{paragraph}".strip()

        if current and len(candidate) > max_chars:
            chunks.append(current)
            current = paragraph
        else:
            current = candidate

    if current:
        chunks.append(current)

    return chunks
Ovaj primer grupiše pasuse dok se ne dostigne grubo ograničenje broja znakova. Namerno je razumljiv, a ne optimalan. Produkcijski sistemi često dele na delove po tokenima, naslovima, sekcijama, granicama rečenica ili strukturi dokumenta. Tabele, izvorni kod, ugovori i API dokumentacija mogu zahtevati različite strategije.
Očuvajte poreklo prilikom deljenja na delove
def build_chunks(documents):
    chunks = []

    for document in documents:
        for index, text in enumerate(chunk_text(document["text"])):
            chunks.append({
                "id": f'{document["source"]}:{index}',
                "source": document["source"],
                "chunk": index,
                "text": text,
            })

    return chunks
Korisni deo nosi više od teksta. Naziv izvora, ID dokumenta, URL, vremenska oznaka, verzija ili odeljak mogu kasnije podržati citiranje, otklanjanje grešaka i provere svežine. Ako se poreklo izgubi tokom unosa, postaje mnogo teže objasniti zašto je određeni odgovor proizveden.
Stvarni primer 2: Strukturirani podaci — Koristite SQL kada je SQL pravi alat
Ne treba svaka eksterna činjenica da prođe kroz semantičku pretragu. Ako pitanje zahteva tačan trenutni zapis, direktan upit baze podataka je obično jasniji i determinističkiji.
import sqlite3

def get_order_status(order_id):
    connection = sqlite3.connect("shop.db")
    cursor = connection.cursor()

    cursor.execute(
        "SELECT status, total, currency FROM orders WHERE id = ?",
        (order_id,)
    )

    row = cursor.fetchone()
    connection.close()

    if row is None:
        return None

    return {
        "order_id": order_id,
        "status": row[0],
        "total": row[1],
        "currency": row[2],
    }

print(get_order_status(4711))
Ako aplikacija već zna da korisnik pita o porudžbini 4711, ugrađivanje cele tabele porudžbina i traženje od semantičke pretrage da ponovo otkrije taj red obično dodaje složenost bez koristi. Snažno pravilo dizajna je: dohvatite strukturirane činjenice strukturiranim upitima; dohvatite nestrukturirano znanje pretragom.
Vraćeni red baze podataka i dalje može biti smešten u kontekst modela kako bi LLM mogao da ga objasni prirodnim jezikom. Ali direktan pristup stanju ili zapisu je konceptualno drugačiji od pretrage korpusa znanja.
Stvarni primer 3: Pretraga punog teksta pre ugrađivanja
Između naivne Python petlje i vektorske pretrage leži zrela klasa sistema leksičkog dohvata. SQLite uključuje FTS5 za pretragu punog teksta, uključujući BM25 rangiranje.
import sqlite3

connection = sqlite3.connect("knowledge.db")
cursor = connection.cursor()

cursor.execute(
    "CREATE VIRTUAL TABLE IF NOT EXISTS docs USING fts5(title, body)"
)

cursor.execute(
    "INSERT INTO docs(title, body) VALUES (?, ?)",
    ("AKM", "The AKM uses 7.62 mm ammunition.")
)

connection.commit()

query = "AKM ammunition"

rows = cursor.execute(
    "SELECT title, body, bm25(docs) AS score "
    "FROM docs WHERE docs MATCH ? "
    "ORDER BY score LIMIT 5",
    (query,)
).fetchall()

for row in rows:
    print(row)

connection.close()
Leksička pretraga je posebno korisna kada su tačna terminologija, kodovi proizvoda, imena, identifikatori ili reči specifične za domen važni. Semantička pretraga nije automatski bolja. Produkcioni sistemi često kombinuju oba signala.
Stvarni primer 4: Semantički dohvat sa ugrađivanjima
Ugrađivanja pretvaraju tekst u numeričke vektore tako da semantički povezani odlomci mogu biti upoređeni čak i kada ne koriste identične reči. Sentence Transformers pruža jednostavnu lokalnu implementaciju.
# pip install sentence-transformers

from sentence_transformers import SentenceTransformer, util

documents = [
    "The AKM uses 7.62 mm ammunition.",
    "A Med Kit restores health.",
    "Vehicle maintenance includes checking oil, brakes and tires.",
    "Account recovery requires access to the registered email address."
]

model = SentenceTransformer(
    "sentence-transformers/multi-qa-mpnet-base-cos-v1"
)

document_embeddings = model.encode_document(
    documents,
    convert_to_tensor=True
)

question = "How do I repair my car?"

query_embedding = model.encode_query(
    question,
    convert_to_tensor=True
)

hits = util.semantic_search(
    query_embedding,
    document_embeddings,
    top_k=2
)[0]

for hit in hits:
    print(round(float(hit["score"]), 3), documents[hit["corpus_id"]])
Upit ne sadrži frazu „održavanje vozila“, ali semantički model i dalje može visoko rangirati taj odlomak jer su koncepti povezani. To je praktični razlog zašto su ugrađivanja uobičajena u RAG sistemima.
Za male kolekcije, ugrađivanja mogu ostati u memoriji. Veći sistemi ih obično čuvaju u indeksu ili bazi podataka sa podrškom za vektore i tamo obavljaju pretragu najbližih suseda. Skladištenje se menja, ali logika ostaje: kodirajte pitanje, pronađite relevantne reprezentacije dokumenata, vratite najbolje dokaze.
Stvarni primer 5: Izgradite kontekst za LLM
Retriver treba da vrati dokaze. LLM zatim treba da primi pitanje plus te dokaze. Održavanje pretrage i generisanja odvojenim čini oba lakšim za pregled i testiranje.
def build_prompt(question, retrieved_documents):
    context = "\n\n".join(
        f'[{doc["id"]}] {doc["text"]}'
        for doc in retrieved_documents
    )

    return f"""
Answer the question using the supplied context.

Rules:
- Do not invent facts that are not supported by the context.
- If the context is insufficient, say so.
- Cite the source IDs you used.

Question:
{question}

Context:
{context}
""".strip()
Instrukcija ne čini model nepogrešivim. Ona jednostavno stvara eksplicitnu granicu dokaza. Model i dalje može pogrešno razumeti dobre dokaze, ignorisati uslov ili preterano generalizovati. Zato se kvalitet pretrage i kvalitet generisanja moraju evaluirati odvojeno.
Stvarni primer 6: Kompletan minimalni pipeline
def answer_question(question, all_documents, call_llm):
    # 1. Retrieve evidence
    retrieved = retrieve(question, all_documents, top_k=3)

    # 2. Build model context
    prompt = build_prompt(question, retrieved)

    # 3. Generate the answer
    answer = call_llm(prompt)

    return {
        "answer": answer,
        "sources": [doc["id"] for doc in retrieved]
    }
Funkcija namerno prima call_llm kao zavisnost. Pretragu ne treba da zanima da li generisanje obavlja cloud model, lokalni model ili drugi provajder. Putanja podataka pripada aplikaciji.
Opcioni generator: OpenAI Responses API
Jedan mogući generator je OpenAI Responses API. Održavanje imena modela u promenljivoj okruženja izbegava hardkodiranje određenog modela u RAG arhitekturu.
# pip install openai

import os
from openai import OpenAI

client = OpenAI()

def call_llm(prompt):
    response = client.responses.create(
        model=os.environ["OPENAI_MODEL"],
        input=prompt,
    )
    return response.output_text
Isti pipeline za pretragu može se povezati sa lokalnim serverom za inferenciju. Ovo je važna arhitektonska tačka: RAG nije vlasništvo LLM provajdera. Aplikacija poseduje izvor, pretragu i sastavljanje konteksta.
Cela arhitektura u jednom pregledu
USER QUESTION
     |
     v
+-------------+
|  Retriever  |
+-------------+
   |       |
   |       +----> SQL / API / state query
   |
   +------------> keyword / full-text search
   |
   +------------> embedding / vector search
                     |
                     v
              relevant evidence
                     |
                     v
+-----------------------------------+
| question + evidence + instructions |
+-----------------------------------+
                     |
                     v
                   LLM
                     |
                     v
                  answer
Ovaj model toka podataka je trajniji od memorisanja jednog framework-a. Biblioteke, baze podataka i prodavci modela će se menjati; granice odgovornosti ostaju.
Uobičajene zablude i načini neuspeha
„RAG znači vektorska baza podataka.“
Ne. Vektorska pretraga je jedna metoda pretrage. RAG može koristiti full-text pretragu, SQL, API-je, grafove znanja, vektorsku pretragu ili njihove kombinacije. Definišući obrazac je pretraga eksternih informacija za generisanje.
„Ako su podaci u PostgreSQL-u, moram ugraditi celu bazu podataka.“
Ne. Strukturirani zapisi obično treba da ostanu upitljivi kao strukturirani zapisi. Embeddings su korisni za semantičku relevantnost, ne kao zamena za determinističke upite.
„Više delova znači bolji odgovor.“
Ne nužno. Dodatni kontekst može uneti šum, konfliktne verzije i irelevantan materijal. Pretraga treba da optimizuje za korisne dokaze, a ne za maksimalni obim.
„Visok skor sličnosti dokazuje odgovor.“
Ne. Sličnost meri relevantnost, a ne istinitost ili primenljivost. Veoma sličan odlomak može biti zastareo, iz pogrešne verzije proizvoda ili važeći samo pod uslovima koji se ne poklapaju sa pitanjem.
„Kada se preuzme ispravan deo, halucinacija je rešena.“
Ne. Pretraga poboljšava utemeljenost, ali ne garantuje verodostojno zaključivanje. Generisanje i dalje zahteva evaluaciju, a radni tokovi visokog rizika mogu zahtevati determinističku validaciju ili ljudski pregled.
„Model je zakazao, pa promenite model.“
Ne nužno. Ispravan izvor je možda nedostajao, bio pogrešno parsiran, loše podeljen, filtriran, rangiran prenisko ili izostavljen iz sastavljenog konteksta. Zamena modela ne bi trebalo da bude prvi dijagnostički korak.
Rubni slučajevi
- Konfliktni dokumenti: dva izvora se mogu ne slagati jer se verzije, jurisdikcije ili proizvodi razlikuju.
- Vremenski osetljive činjenice: semantički relevantan izvor može već biti zastareo.
- Dozvole: pretraživač ne sme da vrati dokumente kojima trenutni korisnik nije ovlašćen da pristupi.
- Višejezične kolekcije: model za ugrađivanje i strategija pretrage moraju podržavati jezike koji se stvarno koriste.
- Tabele i izvorni kod: obično deljenje na pasuse može uništiti strukturu koja je ključna za odgovor.
- Vrlo kratki identifikatori: semantička pretraga može biti slabija od tačnog poklapanja za SKU-ove, ID-ove, kodove grešaka ili akronime.
- Duga pitanja koja zahtevaju nekoliko činjenica: pretraga može zahtevati dekompoziciju, nekoliko pretraga ili ponovno rangiranje umesto jednog top-k upita.
- Hijerarhija izvora: zvanična aktuelna politika može trebati da bude rangirana iznad starijeg, ali semantički bližeg diskusionog dokumenta.
Ograničenja
Python primeri namerno optimizuju za transparentnost, a ne za skalabilnost. Pretraživač po ključnim rečima je naivan, delilac koristi dužinu znakova, SQLite primeri ne uključuju upravljanje vezama za produkciju, a semantički primer drži sve ugrađene vektore u memoriji.
Produkcijski sistem može zahtevati vektorske indekse, ponovne rangere, hibridnu pretragu, parsere dokumenata, keširanje, inkrementalno indeksiranje, verzionisanje izvora, filtere kontrole pristupa, observabilnost, skupove podataka za evaluaciju i rukovanje greškama. Nijedan od tih dodataka ne menja osnovnu arhitekturu; oni čine svaku granicu pouzdanijom.
RAG takođe ne može da stvori dokaze koji ne postoje u skupu izvora. Ako je izvor pogrešan, nepotpun ili zastareo, bolji model za ugrađivanje ne može ga pretvoriti u autoritativno znanje.
Šta bi promenilo ovaj odgovor?
Arhitektura se menja kada zadatak zahteva više od pronalaženja znanja. Status porudžbine uživo zahteva trenutno stanje. Finansijski izračun može zahtevati deterministički kod. Zadatak veb-istraživanja može zahtevati aktivnu pretragu. Radni tok može zahtevati alate koji mogu da upišu podatke nazad u drugi sistem. Autonomni agent može zahtevati planiranje, dozvole i kontrolu izvršavanja pored pretrage.
RAG je stoga najbolje razumeti kao jedan sloj za prikupljanje dokaza unutar većeg AI sistema. Moćan je upravo zato što ima uzak zadatak: pronaći korisne spoljne informacije i smestiti ih u radni kontekst modela.
Zaključak
RAG postaje mnogo lakši za razumevanje kada se uklone nazivi tehnologija. Datoteka je izvor. Baza podataka je izvor. API je izvor. Funkcija pretrage pronalazi dokaze. Upit nosi te dokaze do modela. LLM ih zatim tumači i proizvodi jezik.
Teži deo produkcijskog RAG-a nije pozivanje modela za ugrađivanje. To je izgradnja pouzdane putanje dokaza od originalnog izvora do konačne tvrdnje: očuvanje porekla, odabir prave metode pretrage, održavanje informacija ažurnim, kontrola pristupa, evaluacija pretrage odvojeno od generisanja i znanje kada je direktan poziv baze podataka ili alata bolji od semantičke pretrage.
To je praktični nastavak osnovnog RAG modela: prvo razumeti uloge, zatim učiniti putanju podataka eksplicitnom.
Primarni izvori
- Lewis et al. — Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks — rad iz 2020. koji uvodi RAG formulaciju koja kombinuje generisanje sa pronađenom neparametarskom memorijom.
- Sentence Transformers — Semantic Search — zvanična dokumentacija za semantičku pretragu, ugrađivanje upita i ugrađivanje dokumenata.
- OpenAI — Vector Embeddings — zvanična dokumentacija koja opisuje ugrađivanja kao numeričke reprezentacije koje se koriste za povezanost i pretragu.
- SQLite — FTS5 Extension — zvanična dokumentacija za pretragu punog teksta i BM25 rangiranje u SQLite-u.
- OpenAI — SDKs and CLI — zvanični primer Python SDK-a za Responses API koji se koristi u opcionom primeru generatora.
- What Is RAG? The Simplest Explanation of How It Works — konceptualni prvi deo ove serije.
Related Articles

Memorija AI agenta nije RAG: Kako razdvojiti memoriju, pronalaženje, stanje i kontekst
Memorija agenta, RAG, stanje i kontekst često se koriste kao da su međusobno zamenjivi. Oni to nisu. Ovaj praktični arhitektonski model razdvaja ova četiri sloja, pokazuje gde svaki pripada i objašnjava šta se kvari kada ih sistemi stope u jedno.
Како скенирати и очистити Cloud Linux сервер од малвера

Ollama nije proizvod: Izgradnja aplikacija spremnih za produkciju sa otvorenim LLM-ovima
Pokretanje lokalnog modela pomoću Ollama-e je jednostavno. Izgradnja Open-LLM aplikacije spremne za produkciju je teža: zahteva RAG, kontrolu pristupa, apstrakciju provajdera, evaluaciju, logovanje, disciplinu puštanja u rad i kontrolisani aplikativni sloj oko modela.

Šta je RAG? Najjednostavnije objašnjenje kako funkcioniše
RAG zvuči komplikovano, ali ideja je jednostavna: pre nego što AI odgovori, prvo potraži korisne informacije iz izvora znanja i daje te informacije jezičkom modelu. Ovaj vodič objašnjava RAG, LLM-ove, stanje, memoriju i alate koristeći jedan jednostavan mentalni model.
Sveobuhvatni vodič za Test DEv Enterprise Stajic.de: Arhitektura i najbolje prakse
Istražite arhitektonske principe, prednosti i tehničke detalje upravljanja okruženjem za razvoj i testiranje nivoa preduzeća pomoću Test DEv Enterprise Stajic.de.

Granica valjanosti odgovora: Nedostajući sloj između relevantnosti i pouzdanih AI odgovora
Izvor može biti relevantan, autoritativan i ipak pogrešan za pitanje koje se postavlja. Sloj koji nedostaje je primenljivost: uslovi pod kojima odgovor važi i promene koje ga primoravaju na preispitivanje. Ovaj članak predstavlja Granicu važenja odgovora kao obrazac za dizajn izvora za ljude, AI pretragu i RAG sisteme.
Konverzija HEIC u JPG: Zašto bi trebalo da razmislite o tome i kako funkcioniše
HEIC nudi modernu kompresiju slika i visok kvalitet, ali JPG ostaje najkompatibilniji format. Ovaj vodič objašnjava kada i kako konvertovati HEIC u JPG koristeći Linux alate i automatizaciju.
Prevucite i pustite sa JavaScript-om: Duboka analiza native API za interaktivne meniju strukture
Implementacija funkcionalnosti povlačenja i otpuštanja je ključna za moderne, interaktivne korisničke sučelje. Ovaj članak istražuje tehnološku implementaciju pomoću native HTML5 API-ja za povlačenje i otpuštanje u Vanilla JavaScript i TypeScript-u, sa naglaskom na stvaranje dinamičkih struktura menija.
Sveobuhvatni vodič za metrike u isporuci i upravljanju promenama
Ovaj vodič pruža detaljan pregled osnovnih metrika za isporuku i upravljanje promenama u preduzećima, pomažući timovima da mere performanse, optimizuju procese i podstiču kontinuirano poboljšanje. Otkrijte ključne indikatore, metode izračunavanja i najbolje prakse za usklađivanje metrika sa poslovnim ishodima.
Od istraživačkog protokola do opšteg okvira za AI rezonovanje
Metodologija razvijena za rigorozno istraživanje uz pomoć veštačke inteligencije može se generalizovati daleko izvan samog istraživanja. Odvajanjem dokaza od pretpostavki, testiranjem konkurentnih hipoteza, kontrolisanjem uokvirivanja upita, traženjem protivdokaza i primenom validatora specifičnih za domen, ista arhitektura rasuđivanja može unaprediti otklanjanje grešaka, dizajn softvera, strategiju, tehničku analizu i podršku pri odlučivanju uz pomoć veštačke inteligencije.
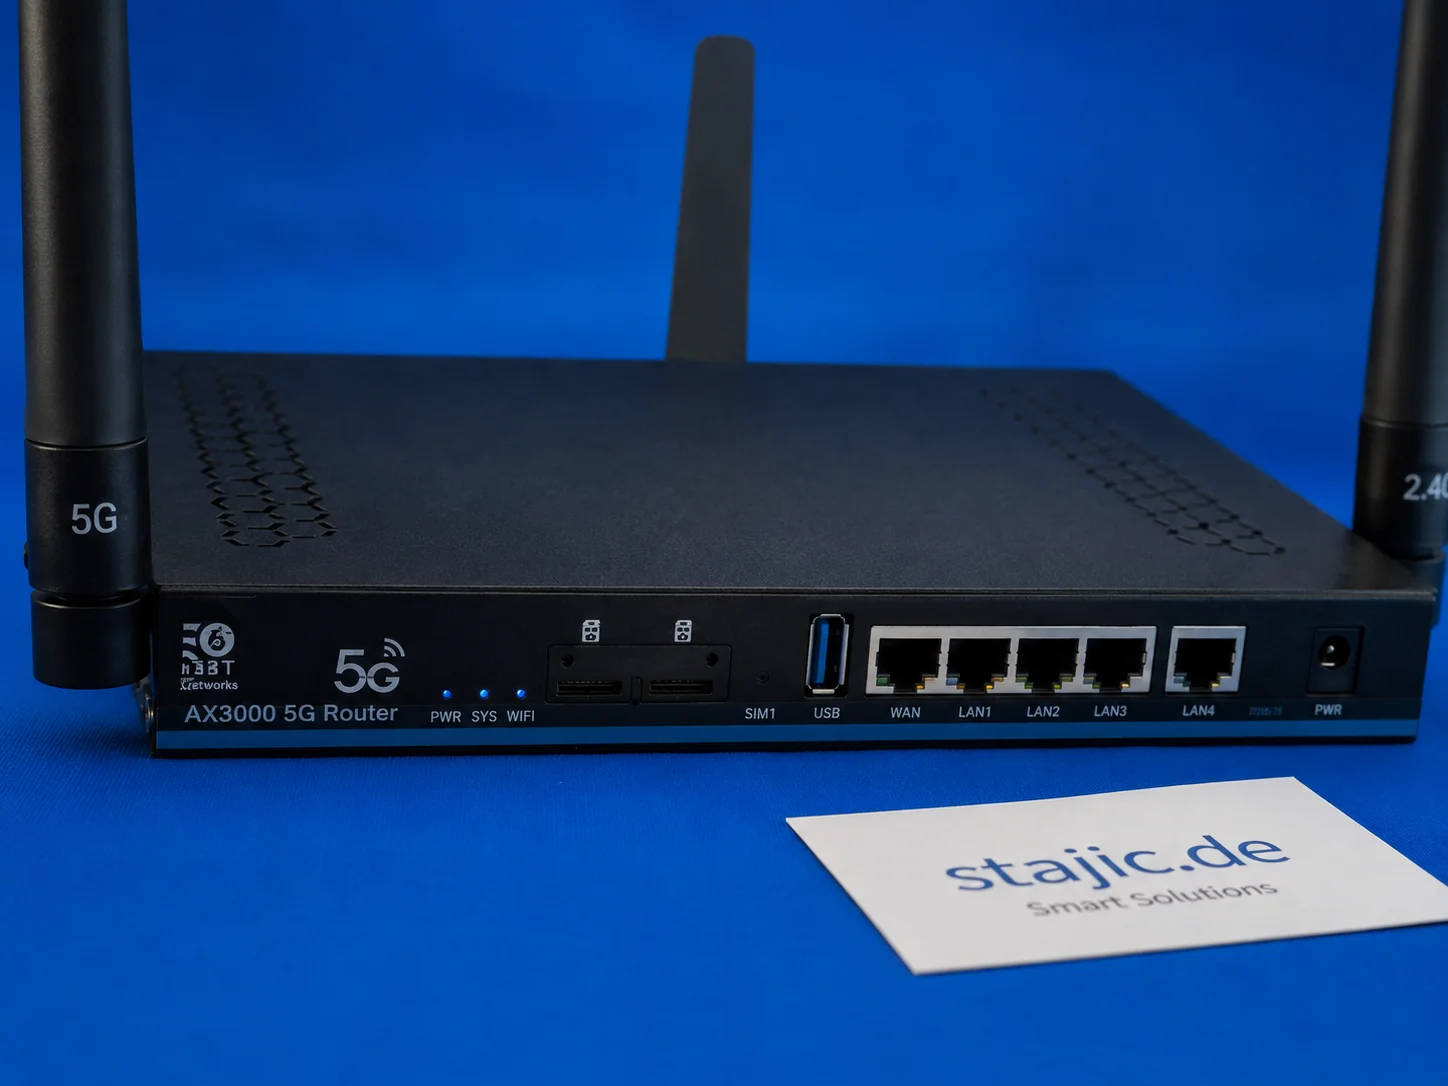
Quectel RM500U-EA u ZBT Z8102AX: 5G opsezi, o2 Nemačka i ponašanje signala u stvarnom svetu
ZBT Z8102AX koristi Quectel RM500U-EA modem za 4G i 5G povezivost. U prvom praktičnom testu, ruter se uspešno povezao na o2 Germany sa LTE Band 3 i NR n28. Modem radi, ali dublja dijagnostika poput RSRP, RSRQ, SINR, zaključavanja opsega i ponašanja ćelije još uvek zahteva odgovarajuće testiranje.

Migracija sa OpenAI Agents SDK na Agents API: Šta se zapravo menja arhitektonski?
Migracija sa OpenAI Agents SDK na novi Agents API nije samo preimenovanje importa. Granica izvršnog okruženja se menja: petlja agenta, trajna sesija, orkestracija, sažimanje konteksta i oporavak premeštaju se ka upravljanom okviru. Ovaj vodič pokazuje šta treba premestiti, šta treba da ostane u vašoj aplikaciji i kako da dokažete migraciju pre prelaska.