
Memorija AI agenta nije RAG: Kako razdvojiti memoriju, pronalaženje, stanje i kontekst
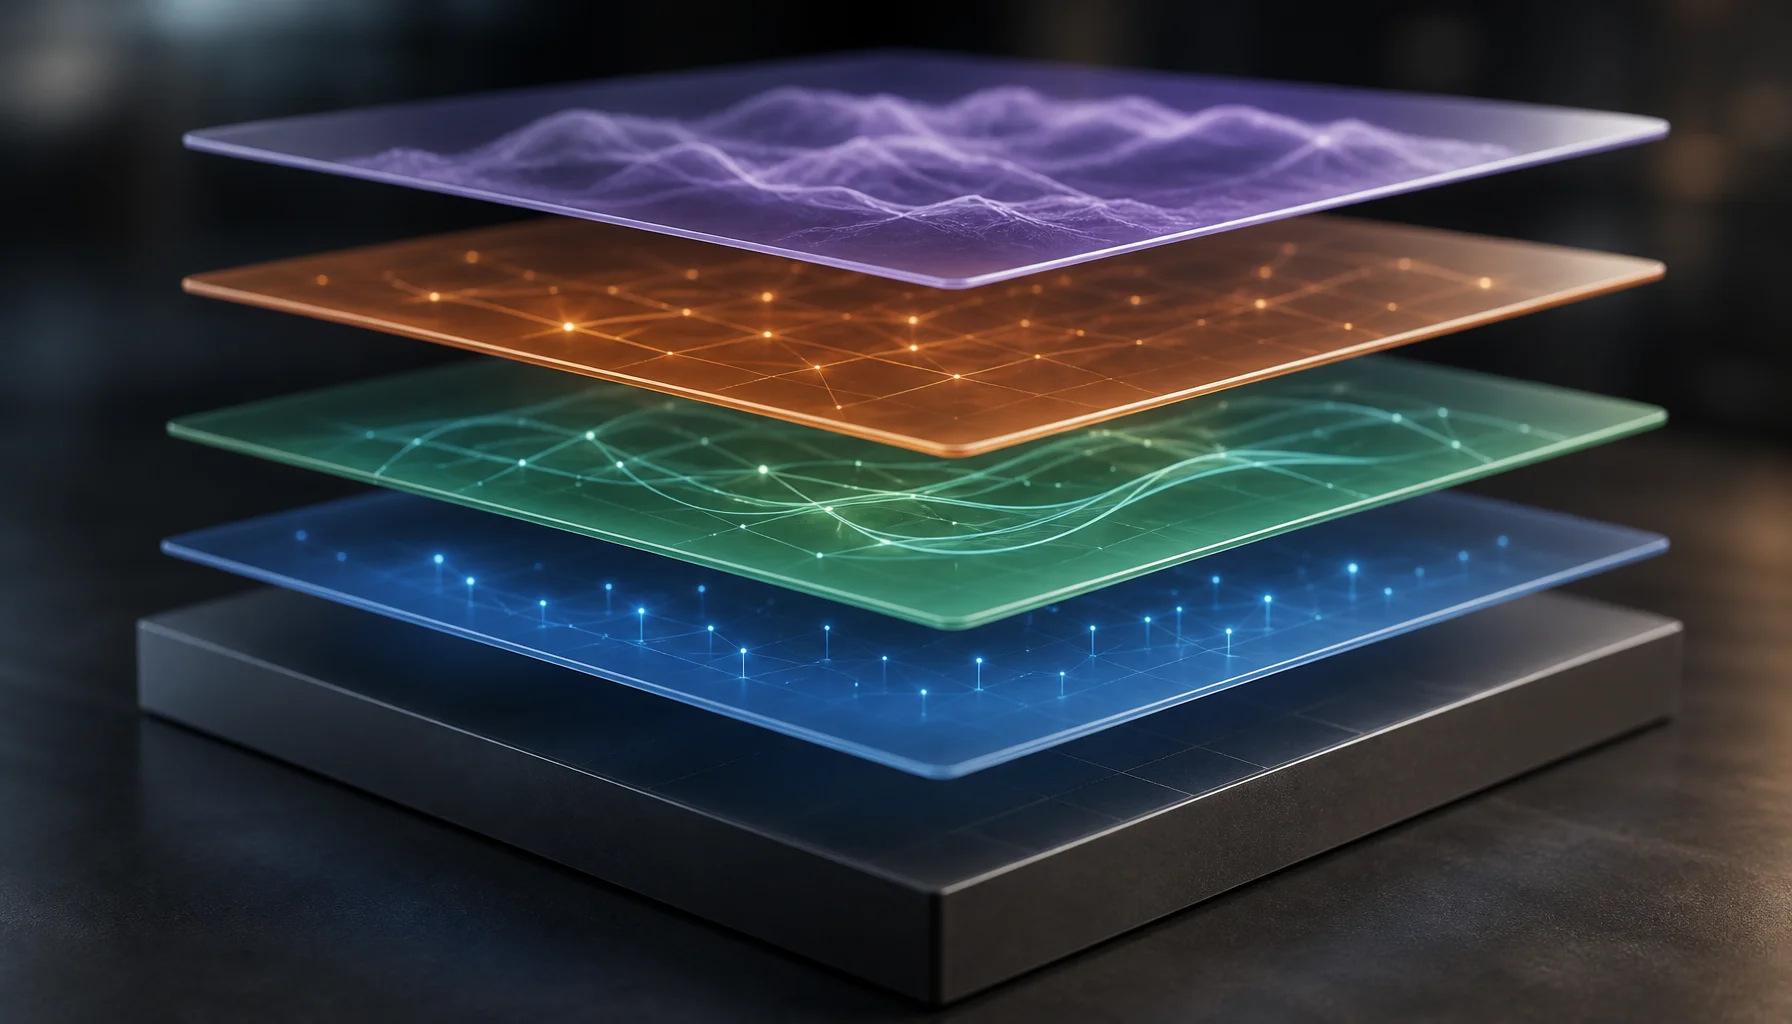
O memoriji AI agenata, generisanju potpomognutom preuzimanjem (RAG), stanju u toku izvršavanja (runtime state) i kontekstu modela često se raspravlja kao da su zamenljivi pojmovi. Oni to nisu. Njihovo svođenje na jedan koncept otežava rasuđivanje o agentskim sistemima, čini njihovo debagovanje težim i povećava šansu da postanu zastareli ili nebezbedni.
Kategorijalna greška: tretiranje svega što deluje postojano kao memorije
Vektorska baza podataka može čuvati fragmente razgovora. Objekat sesije može prenositi nedavne korake u dijalogu. Red u bazi podataka može sadržati trenutni status radnog toka. Modul za sažimanje može sažeti prethodni rad. Mehanizam za preuzimanje može dohvatiti stare dokaze. Sve ovo može učiniti da izgleda kao da se agent „seća“, ali ovi elementi nemaju istu semantiku.
Ova razlika je važna jer se zahtevana pravila tačnosti razlikuju. Trenutno stanje mora biti autoritativno i sveže. Memoriji su potrebna pravila životnog ciklusa za upisivanje, reviziju, zaboravljanje i rešavanje konflikata. Preuzimanju je potrebna relevantnost i kvalitet odabira dokaza. Kontekstu je potrebna disciplina budžeta tokena i zaštita od irelevantnog ili kontradiktornog materijala.
Četvoroslojna arhitektura: stanje, memorija, preuzimanje, kontekst
| Sloj | Ključno pitanje | Tipični primeri | Primarna briga o tačnosti |
|---|---|---|---|
| Stanje | Šta je sada tačno? | Status zadatka, sadržaj korpe, korak u radnom toku, aktivne dozvole, trenutno stanje igre | Svežina i autoritativnost |
| Memorija | Šta iz prošlosti treba da opstane? | Korisnička preferencija, prethodna odluka, naučeno ograničenje, rešeni problem, trajna činjenica o projektu | Životni ciklus, revizija, poreklo, zaboravljanje |
| Preuzimanje | Koje informacije sada treba izabrati? | Vektorska pretraga, pretraga po ključnim rečima, pretraga grafa, ponovno rangiranje, pretraga dokumenata | Relevantnost i odabir dokaza |
| Kontekst | Šta model vidi za ovaj poziv? | Sistemske instrukcije, trenutni zahtev, preuzeti odlomci, rezultati alata, sažeci | Korisnost po tokenu, redosled, doslednost, šum |
1. Stanje: šta je sada tačno
Stanje pripada pokrenutom sistemu, a ne sećanju modela. Ako je porudžbina otkazana, primena (deployment) pauzirana, korisnik izgubi dozvolu, ili zadatak pređe iz statusa „u toku“ u „odobreno“, autoritativna vrednost treba da potiče iz sistema koji je vlasnik te činjenice.
Opasan dizajn je dopuštanje da stari sažetak razgovora postane zamena za trenutno stanje. Agent se može tačno sećati da je porudžbina juče bila aktivna i svejedno biti u krivu danas. Stanju je stoga potrebno eksplicitno vlasništvo, verzionisanje ili vremenske oznake tamo gde je to relevantno, kao i putanja za ponovno očitavanje izvora istine pre preduzimanja radnji sa značajnim posledicama.
2. Memorija: šta iz prošlosti treba da opstane
Memorija nije prosto „sve što možemo da sačuvamo“. Koristan sloj memorije odlučuje šta zaslužuje trajnost, u kom obliku, koliko dugo, sa kojim poreklom i pod kojim uslovima mora biti revidirano ili uklonjeno.
Nedavna istraživanja o memoriji agenata sve više tretiraju čuvanje sirovih transkripata kao nedovoljno. Microsoftov rad PlugMem fokusira se na transformaciju sirovih istorija interakcija u strukturirano znanje za višekratnu upotrebu. Memora razdvaja bogat sačuvani sadržaj od lakših apstrakcija i smernica za preuzimanje, tako da sistemi dugog vremenskog horizonta ne moraju da biraju između detalja i skalabilnog pristupa.
3. Preuzimanje: šta sada treba izabrati
Preuzimanje je mehanizam odabira. Ono može pretraživati spoljne dokumente, interne baze znanja, sačuvane memorije, dnevnike rada, grafove, baze podataka ili kombinovane izvore. RAG se obično nalazi ovde: preuzmi dokaze, ubaci odabrani materijal u radni ulaz modela, a zatim generiši odgovor.
Taj mehanizam ne postaje memorija samo zato što pretraživani korpus sadrži prošle interakcije. Isti mehanizam za preuzimanje može pretraživati dokumente o pravilima koje agent nikada nije iskusio, podatke o proizvodima iz drugog sistema ili prethodne odluke korisnika. Preuzimanje opisuje kako se informacije biraju; memorija opisuje zašto neke informacije opstaju kroz vreme i kako se tom trajnošću upravlja.
4. Kontekst: šta model zapravo može da iskoristi u ovom trenutku
Kontekst je sloj okrenut prema modelu. Anthropic opisuje inženjering konteksta kao odlučivanje o tome koja konfiguracija konteksta ima najveću verovatnoću da proizvede željeno ponašanje, pri čemu kontekst predstavljaju tokeni dostupni modelu tokom generisanja. OpenAI-jeve smernice za memoriju sesije slično tretiraju skraćivanje i kompresiju kao tehnike upravljanja kontekstom za dugotrajne interakcije agenata.
Zbog toga sistem može imati odličnu memoriju, a da ipak podbaci. Relevantna memorija može postojati, ali da ne bude preuzeta. Može biti preuzeta, ali smeštena u kontekst pored snažnijeg protivrečnog teksta. Može biti komprimovana do te mere da presudni detalj nestane. Ili model može primiti toliko materijala da korisni dokazi budu razvodnjeni šumom.
Kako slojevi interaguju
Jedan mogući produkcioni tok
Zašto RAG nije memorija
Najjednostavniji test je sledeći: RAG sistem može da preuzme informacije koje agent nikada ranije nije video. To samo po sebi pokazuje da su preuzimanje i memorija različite apstrakcije.
RAG odgovara na pitanje: „Koje dokaze treba da dobavim?“ Sistem memorije dodatno mora da odgovori na pitanja kao što su: „Da li ovaj događaj treba da postane trajno znanje?“, „Da li ova nova informacija zamenjuje stariju memoriju?“, „Može li se ovoj memoriji i dalje verovati?“, „Kome je dozvoljeno da je čita?“ i „Kada je treba zaboraviti?“
Test razdvajanja na četiri sloja
Kada se neka funkcionalnost nazove „memorijom“, postavite sledeća četiri pitanja. Odgovori obično otkrivaju o kom sloju se zapravo radi.
| Pitanje | Ako je odgovor da, prvenstveno se bavite sledećim |
|---|---|
| Da li ovo predstavlja trenutno merodavno stanje zadatka ili okruženja? | Stanje |
| Mora li ova informacija da preživi trenutno izvršavanje zato što beleži korisno prethodno iskustvo, preferenciju ili odluku? | Memorija |
| Da li je glavni problem odlučivanje o tome koje su sačuvane ili spoljašnje informacije relevantne za trenutni zahtev? | Preuzimanje |
| Da li je glavni problem odlučivanje o tome koje informacije treba postaviti unutar trenutnog poziva modela? | Kontekst |
Jedna komponenta može učestvovati u više slojeva. Baza podataka može skladištiti i stanje i memoriju. Vektorski indeks može preuzimati i spoljašnje znanje i memorije. Razdvajanje je semantičko, ne nužno fizičko.
Modeli otkazivanja uzrokovani spajanjem slojeva
| Model otkazivanja | Šta se dogodilo | Rezultat |
|---|---|---|
| Zastarelo stanje prerušeno u memoriju | Veruje se starom rezimeu umesto ponovnog čitanja merodavnog sistema | Agent postupa na osnovu činjenica koje su nekada bile tačne |
| Memorija tretirana kao nepromenljiva činjenica | Prethodna preferencija ili odluka je sačuvana bez pravila revizije | Zamenjena informacija nastavlja da utiče na buduće odgovore |
| Pogodak preuzimanja tretiran kao istina | Visoka sličnost je pogrešno protumačena kao činjenični autoritet | Dokazi koji deluju relevantno, ali su netačni, preuzimaju primat |
| Preopterećenje konteksta | Ubačeno je previše preuzetih odlomaka, memorija, zapisa i instrukcija | Presudni dokazi bivaju razvodnjeni ili u suprotnosti sa drugima |
| Nekontrolisano upisivanje memorije | Interpretacije koje je model generisao automatski se skladište kao trajna memorija | Greške postaju trajne i same sebe pojačavaju |
| Nedostatak granice porekla | Sistem ne može da razlikuje izjavu korisnika, izvornu činjenicu, zaključak modela i generisani rezime | Kasnije preuzimanje gubi dokazni status informacije |
Šta treba zapamtiti, preuzeti, ponovo izračunati ili ponovo pročitati?
| Tip informacije | Preporučeni tretman | Razlog |
|---|---|---|
| Trenutna dozvola, status porudžbine, inventar, status toka posla | Ponovo pročitati merodavno stanje | Ažurnost je važnija od prisećanja |
| Stabilna korisnička preferencija koju je korisnik izričito naveo | Memorija, sa semantikom izmene/brisanja | Korisna je kroz više sesija i u vlasništvu je korisnika |
| Odluka doneta tokom dugotrajnog projekta | Memorija sa vremenskom oznakom, poreklom i pravilima zamene | Istorijat je važan, ali se odluke mogu promeniti |
| Specifikacija proizvoda ili javni dokument o pravilima | Preuzeti iz izvora | Spoljašnje znanje treba da ostane povezano sa svojim dokazima |
| Izvedena metrika koja se može jeftino ponovo izračunati | Ponovo izračunati | Izbeći perzistiranje zastarelih izvedenih vrednosti |
| Dugačak sirovi izlaz alata | Sačuvati eksterno; preuzeti ili rezimirati po potrebi | Ne trošiti kontekst trajno |
| Hipoteza modela ili nesigurna interpretacija | Ne unapređivati automatski u trajnu memoriju | Zaključak nije ekvivalentan činjenici |
Sistemu memorije je potrebna politika upisa, a ne samo politika preuzimanja
Diskusije o RAG arhitekturi često se fokusiraju na kvalitet pretrage: segmentaciju (chunking), ugrađene reprezentacije (embeddings), ponovno rangiranje, hibridnu pretragu i utemeljenje (grounding). Dugoročna memorija uvodi drugu stranu problema: šta uopšte sme da uđe u trajnu bazu podataka?
Za trajnu memoriju agenata, praktična politika upisa treba da klasifikuje potencijalnu memoriju, očuva poreklo (provenance), otkrije konflikte sa postojećim unosima, razlikuje zapažanje od zaključivanja, definiše osetljivost i opseg pristupa, i odluči da li informacija treba da istekne, da bude revidirana ili da zahteva potvrdu korisnika.
Poreklo je most između memorije i pouzdanih dokaza
Unos u memoriju bi idealno trebalo da zadrži dovoljno podataka o poreklu kako bi odgovorio na pitanja: odakle ovo potiče, kada je primećeno, ko ili šta je to tvrdilo, da li je podatak pružio korisnik ili ga je model zaključio, koji izvor ga podržava i da li ga je nešto zamenilo?
Bez porekla, sažeta memorija može postati merodavnija od dokaza koji su je stvorili. Ovo je posebno rizično kod agenata koji dugo rade, gde se sažeci i apstrakcije iznova koriste. Sistem može sačuvati zaključak, a izgubiti uslove pod kojima je taj zaključak bio važeći.
Više memorije ne znači više konteksta
Dugovečni agent može akumulirati gigabajte stanja, istorije, dokumenata i naučenih informacija. Modelu nije potrebno — i obično ne bi ni trebalo da dobije — sve to za svaki korak. Svrha pronalaženja, sažimanja, zbijanja i strukturirane memorije jeste pretvaranje velikog prostora trajnih informacija u mali, relevantan radni kontekst.
To je takođe razlog zašto veći kontekstualni prozori ne eliminišu potrebu za arhitekturom memorije. Kapacitet smanjuje deo pritiska, ali ne rešava svežinu, autoritet, protivrečne dokaze, opseg privatnosti, kvalitet upisa, reviziju niti odlučivanje o tome šta zaslužuje pažnju.
Kontrolna lista za produkcioni dizajn
- Definišite koji sistemi poseduju autoritativno stanje tokom izvršavanja.
- Definišite koje informacije ispunjavaju uslove da postanu trajna memorija.
- Održavajte jasnu razliku između činjenica koje je pružio korisnik, spoljnih dokaza i zaključaka modela.
- Pridružite vremenske oznake, poreklo, opseg i semantiku revizije važnim memorijama.
- Tretirajte relevantnost pretrage drugačije od činjeničnog autoriteta.
- Gradite kontekst s namerom umesto da ubacujete sav preuzeti materijal.
- Ponovo pročitajte promenljive činjenice umesto da verujete starim memorijama.
- Ponovo izračunajte jeftine izvedene vrednosti kada bi zastarelost bila skupa.
- Testirajte upise u memoriju jednako pažljivo kao i čitanja iz memorije.
- Merite greške odvojeno: greška stanja, greška memorije, greška pretrage, greška konstrukcije konteksta, greška rezonovanja i greška akcije.
Šta bi promenilo ovaj odgovor?
Granica između ovih slojeva može se pomerati kako se platforme za agente razvijaju. Provajder može ponuditi upravljanu uslugu memorije koja interno obavlja skladištenje, reviziju, pretragu, sažimanje i konstrukciju konteksta. To može objediniti komponente implementacije, ali ne eliminiše arhitektonska pitanja. I dalje morate znati da li je vraćena stavka trenutno stanje, trajna memorija, pronađeni dokaz ili jednostavno tekst ubačen u kontekst.
Preporuka bi se takođe promenila za sisteme bez kontinuiteta između sesija, sisteme gde svaki zadatak počinje od čistog, nepromenljivog korpusa ili za strogo ograničene radne tokove gde celokupno relevantno stanje bezbedno staje unutar jednog poziva. U tim slučajevima, namenski sloj dugoročne memorije može uneti složenost bez dovoljne vrednosti.
Ograničenja
Terminologija u sistemima agenata se i dalje brzo razvija. Neki okviri istoriju razgovora nazivaju „memorijom“, drugi koriste „sesija“, „kontrolna tačka“, „skladište“, „kontekst“ ili „stanje“. Istraživački sistemi takođe definišu memoriju na različitim nivoima, od trajnog pretraživanja do naučene unutrašnje adaptacije. Model u ovom članku namerno razdvaja operativne odgovornosti umesto da pokušava da nametne jedan univerzalni rečnik.
Zaključak
Korisno pitanje nije „Da li ovaj agent ima memoriju?“ već: Šta je stanje, šta se čuva iz iskustva, kako se pronalaze relevantne informacije i šta na kraju stiže do modela kao kontekst?
Kada se te odgovornosti razdvoje, odluke o dizajnu postaje lakše testirati. Zastarele činjenice se mogu pratiti do vlasništva nad stanjem. Loš odziv se može pratiti do životnog ciklusa memorije ili dohvatanja informacija. Preopterećeni promptovi se mogu pratiti do konstrukcije konteksta. Uporne halucinacije se mogu pratiti do politike upisivanja i porekla. RAG ostaje važan alat, ali je samo jedan deo pouzdane arhitekture dugotrajnih agenata.
Česta pitanja
Memorija AI agenta, RAG, stanje i kontekst
Da li je RAG isto što i memorija AI agenta?
Da li je vektorska baza podataka memorija agenta?
Da li veći kontekstni prozor uklanja potrebu za memorijom?
Da li trenutno stanje aplikacije treba čuvati kao memoriju?
Rečnik pojmova
Ključni pojmovi
- Stanje (State)
- Trenutno autoritativno stanje zadatka, aplikacije, korisnika, toka rada ili okruženja.
- Memorija (Memory)
- Informacije iz prethodnog iskustva ili interakcije koje opstaju zato što mogu biti korisne kasnije i podležu pravilima životnog ciklusa.
- Dohvatanje (Retrieval)
- Mehanizam koji se koristi za odabir potencijalno relevantnih informacija iz memorije, spoljnog znanja, baza podataka, grafova ili drugih skladišta.
- Kontekst (Context)
- Informacije koje su zapravo dostupne jezičkom modelu tokom određenog koraka inferencije ili generisanja.
- RAG
- Generisanje potpomognuto dohvatanjem (Retrieval-augmented generation): obrazac u kojem se spoljne ili sačuvane informacije dohvataju i prosleđuju generativnom modelu radi poboljšanja trenutnog izlaza.
- Poreklo (Provenance)
- Metapodaci koji opisuju odakle informacija potiče, kada je uočena, ko ili šta ju je tvrdilo i kako je transformisana.
Primarni izvori i dodatna literatura
OpenAI — Context Engineering: Short-Term Memory Management with SessionsSmernice kompanije OpenAI o skraćivanju i kompresiji za kontekst dugotrajnih agenata.
OpenAI — Sandbox AgentsDokumentacija koja prikazuje trajnu memoriju kao sposobnost sa progresivnim otkrivanjem i ponašanjem čitanja/pisanja.
Anthropic — Effective Context Engineering for AI AgentsInženjerske smernice o uređivanju ograničenog konteksta modela radi pouzdanog ponašanja agenata.
Microsoft Research — MemoraIstraživanje o balansiranju apstrakcije i specifičnosti u dugoročnoj memoriji agenata.
Microsoft Research — PlugMemIstraživanje o pretvaranju sirove istorije interakcija agenata u višekratno upotrebljivo strukturirano znanje.
Microsoft Research — Agentic Context Engineering (ACE)Istraživanje o razvijanju konteksta kao strukturiranih priručnika umesto uzastopnog prepisivanja ili kompresovanja svega.
Related Articles
Izvor istine u AI sistemima: Odakle pouzdano znanje zaista dolazi
Izvor istine definiše koji je izvor merodavan za određenu činjenicu ili stanje. Saznajte kako se razlikuje od RAG-a, porekla, memorije, konteksta, vektorskih baza podataka i sistema evidencije.

Suverena AI: Kontrola modela, podataka, infrastrukture i zavisnosti
Suverena AI se odnosi na efektivnu kontrolu nad modelima, podacima, infrastrukturom, softverom, operacijama i strateškim zavisnostima — a ne samo na to gde je AI model hostovan.
Šta je RAG? Najjednostavnije objašnjenje kako funkcioniše
RAG zvuči komplikovano, ali ideja je jednostavna: pre nego što AI odgovori, prvo potraži korisne informacije iz izvora znanja i daje te informacije jezičkom modelu. Ovaj vodič objašnjava RAG, LLM-ove, stanje, memoriju i alate koristeći jedan jednostavan mentalni model.
Vektorske baze podataka, ugrađivanja i ponovno rangiranje: Tri različita dela pretraživanja
Embedinzi predstavljaju značenje, vektorske baze podataka pronalaze kandidate, a rerangirači prečišćavaju rezultate. Saznajte kako se ova tri sloja pronalaženja razlikuju i kako rade zajedno u RAG-u.
RAG nije uspeo — ali koji sloj je zapravo zakazao? Dijagnostička metoda
Kada je RAG odgovor pogrešan, kriviti pretragu ili model je previše neodređeno. Ova dijagnostička metoda izoluje pokrivenost izvora, konstrukciju upita, pretragu, rangiranje, sastavljanje konteksta, generisanje, pripisivanje dokaza i svežinu—tako da se stvarni kvar može reprodukovati i ispraviti.
Odakle LLM dobija svoje podatke? RAG izvori podataka u Python-u
LLM ne zna magično vaše fajlove, baze podataka ili API-je. Ovaj praktični nastavak RAG serije pokazuje, uz jednostavan Python, kako eksterni podaci postaju dokazi koji se mogu pronaći: od tekstualnih fajlova i SQL-a do pretrage punog teksta, embeddinga, sastavljanja konteksta i konačnog LLM poziva.
Agentna AI objašnjena: Kada AI sistem može da planira, koristi alate i deluje
Agentna AI koristi modele unutar višekoračnih izvršnih petlji gde mogu da biraju alate, posmatraju rezultate, ažuriraju stanje i prilagode svoju sledeću akciju unutar eksplicitnih granica izvršavanja i dozvola.
GPU nije proizvod: Privatna AI arhitektura spremna za budućnost
Privatna AI infrastruktura ne bi trebalo da bude projektovana oko jednog GPU-a ili jednog modela. Otporniji pristup kombinuje brze GPU-ove za inferenciju, memorijski bogate AI sisteme, čvorove za fizički AI i opcione vodeće modele u oblaku iza sloja za rutiranje koji prepoznaje mogućnosti.

Air-Gapped AI: Kako AI sistemi funkcionišu bez interneta ili pristupa oblaku
Air-gapped AI pokreće modele, RAG i AI aplikacije unutar izolovanog bezbednosnog domena bez internet ili cloud zavisnosti. Saznajte kako modeli, podaci, ažuriranja i alati funkcionišu offline.
Šta je arhitekta AI platforme? Modeli, podaci, izvršno okruženje, bezbednost i operacije
Arhitekta AI platforme projektuje višekratno upotrebljive AI temelje kroz modele, provajdere, pretragu, agente, identitet, bezbednost, evaluaciju, opservabilnost i operacije.
Kada bi AI trebalo da prestane da veruje sopstvenom znanju? — Okidač za pretragu
AI model ne zahteva pretragu za svako pitanje. Važan problem je znati kada njegovo interno znanje više nije dovoljno. Okidač za pretragu je praktična granica odlučivanja koja određuje kada AI sistem treba da prestane da se oslanja isključivo na znanje modela i pribavi spoljne dokaze pre odgovaranja.
Šta je kontekstualno inženjerstvo? Šta model prima pre nego što odgovori
Inženjering konteksta osmišljava koje informacije AI model prima pre inferencije, uključujući promptove, pretragu, memoriju, stanje aplikacije, rezultate alata i istoriju konverzacije.