
Il prompt fa parte del bias: come il framing dell'IA modella il ragionamento
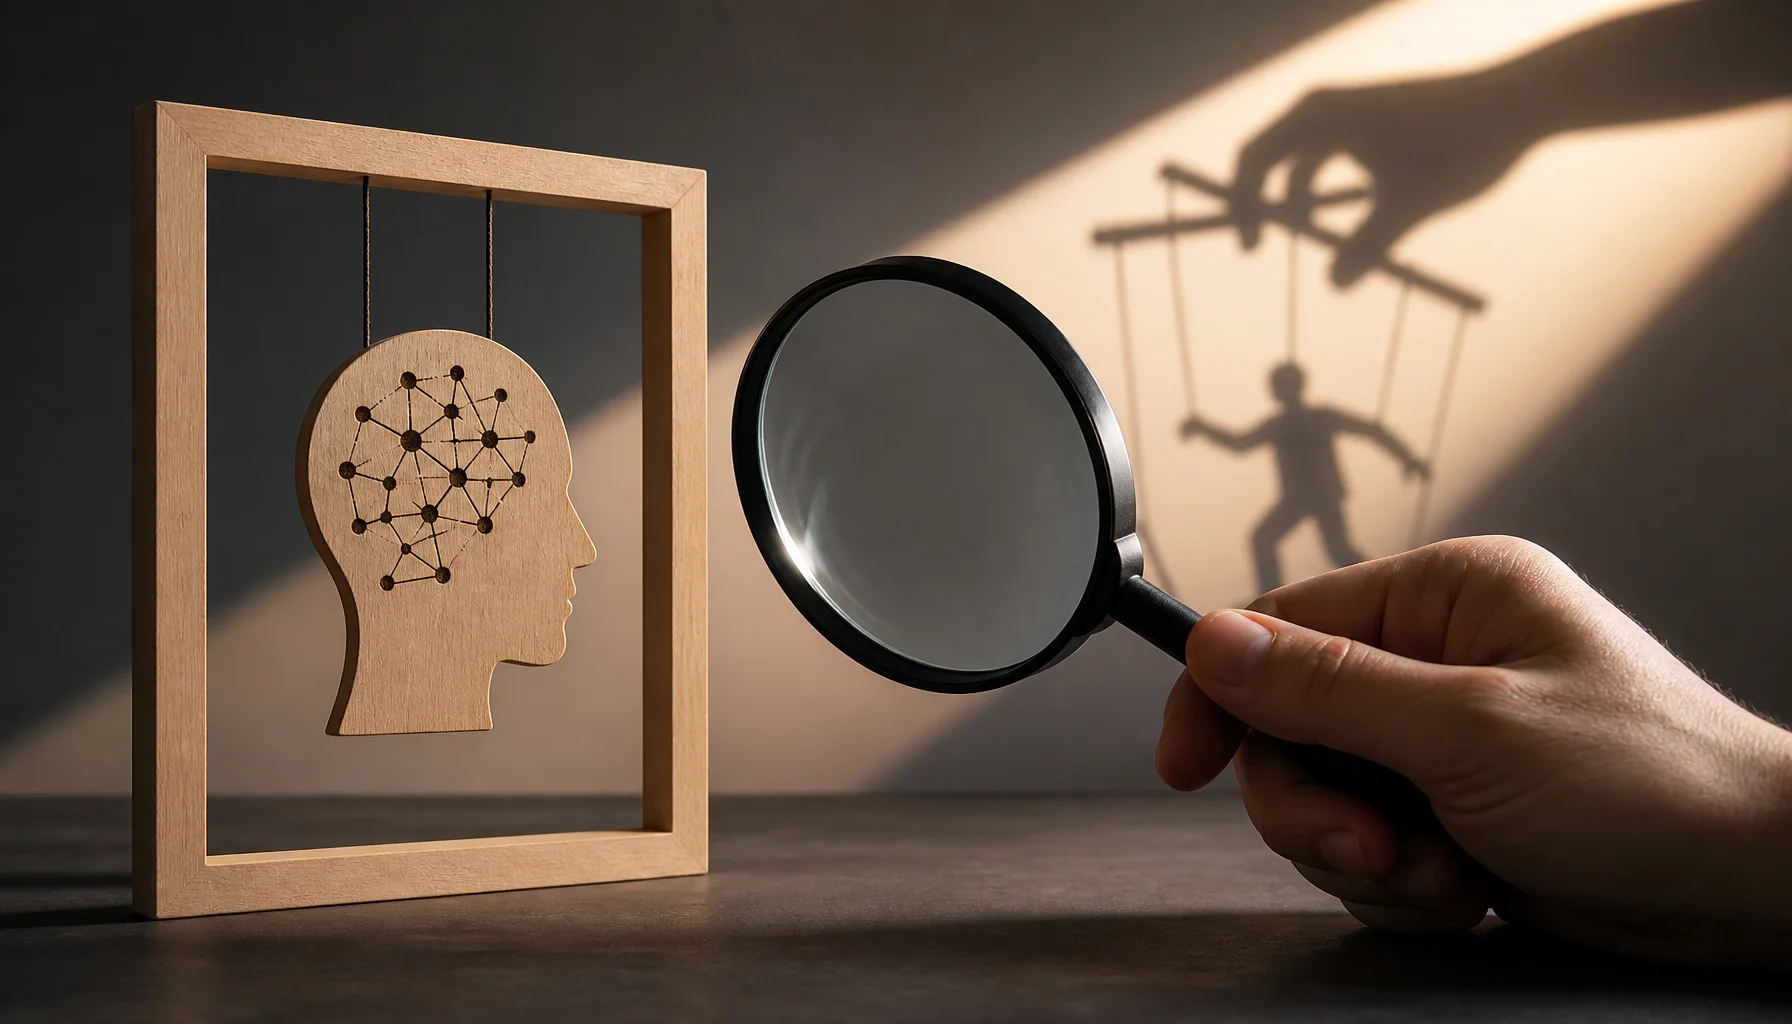
Un prompt viene solitamente trattato come un'istruzione inviata a un modello di IA: descrivi il compito in modo sufficientemente chiaro, fornisci il contesto necessario e il modello dovrebbe produrre una risposta migliore.
Quel modello è incompleto.
Il prompt non si limita a descrivere il problema. Partecipa anche alla costruzione dell'ambiente di ragionamento in cui il problema viene valutato. La sua formulazione, l'ordine degli elementi, i presupposti, le etichette, gli esempi, la prospettiva richiesta e persino la convinzione dichiarata dall'utente possono influenzare l'output risultante.
Il prompt non è esterno al processo di ragionamento. È una delle variabili al suo interno.
Questa distinzione è centrale nella metodologia introdotta in Beyond Prompt Engineering: A Methodology for More Reliable AI Reasoning. Se l'obiettivo è un ragionamento affidabile piuttosto che una semplice generazione di testo utile, il prompt stesso deve essere trattato come una potenziale fonte di bias metodologico.
Qualità del prompt e neutralità del prompt sono problemi diversi
Il prompt engineering cerca normalmente di migliorare la chiarezza. Le richieste ambigue vengono sostituite con requisiti espliciti. Viene aggiunto contesto rilevante. Vengono definite le strutture di output desiderate. I vincoli vengono resi visibili.
Tutto questo può migliorare la qualità di una risposta.
Ma un prompt più dettagliato non è automaticamente un prompt più neutrale. In effetti, dettagli aggiuntivi possono introdurre presupposti ulteriori. Un prompt attentamente progettato può vincolare un modello in modo così efficace da fargli produrre una risposta eccellente a una domanda il cui inquadramento di base non è mai stato messo in discussione.
Si tratta quindi di due diversi obiettivi di ottimizzazione:
- Qualità del prompt: il modello comprende ed esegue adeguatamente il compito richiesto?
- Robustezza epistemica: la conclusione essenziale rimarrebbe difendibile se venissero modificati presupposti discutibili o scelte di inquadramento nel prompt?
Un prompt può ottenere un punteggio elevato sul primo criterio pur risultando carente sul secondo.
Non esiste un prompt perfettamente neutrale
Ogni prompt non banale compie delle scelte.
Decide quali informazioni includere e quali omettere. Determina quali concetti vengono nominati. Può definire spiegazioni plausibili prima che il modello abbia esaminato le prove. Stabilisce terminologia, ambito ed enfasi. Nelle attività comparative può determinare quale opzione compare per prima. Nelle attività di ricerca può affermare una relazione ipotizzata prima di chiedere se tale relazione esista effettivamente.
Queste decisioni non invalidano necessariamente la risposta. Tuttavia, significano che il prompt non può essere trattato automaticamente come un canale trasparente attraverso cui un processo di ragionamento altrimenti indipendente osserva il problema.
Brucks e Toubia descrivono un fenomeno correlato definendolo prompt architecture. Attraverso esperimenti su larga scala che hanno coinvolto GPT-3, GPT-4 e Llama 3.1, hanno scoperto che scelte progettuali apparentemente secondarie — tra cui l'ordine delle risposte, le etichette, il framing e le richieste di giustificazione — potevano influenzare sistematicamente gli output del modello.
Ciò è importante perché questi effetti non si limitavano a prompt palesemente manipolatori. Alcune delle caratteristiche influenti erano ordinarie decisioni strutturali che l'utente deve necessariamente prendere ogni volta che formula una domanda.
L'assenza dell'intenzione di influenzare il modello non implica l'assenza di un effetto di framing.
Un esempio concreto: ordine ed etichette
Il problema dell'architettura del prompt diventa più evidente nelle attività di confronto controllate.
In uno degli esperimenti riportati da Brucks e Toubia, a GPT-4 è stato chiesto di confrontare insiemi di elementi in condizioni di prompt variate sistematicamente. Dopo aver escluso le risposte incomplete, lo studio ha analizzato 5.447 osservazioni.
In condizioni in cui un rispondente imparziale avrebbe dovuto selezionare ciascuna posizione di risposta con la stessa frequenza, GPT-4 ha selezionato la prima opzione nel 63,21% delle osservazioni. Ha inoltre selezionato l'opzione etichettata con B rispetto a quella con C nel 74,27% delle osservazioni.
Questi numeri non devono essere generalizzati in affermazioni come 'GPT-4 preferisce sempre la prima opzione' o 'tutti i modelli linguistici preferiscono B'. Descrivono condizioni sperimentali particolari. La loro rilevanza metodologica risiede altrove: proprietà arbitrarie del prompt hanno modificato in modo misurabile le risposte del modello.
Lo stesso studio ha anche rilevato che il semplice fatto di informare il modello che l'ordine e le etichette erano stati randomizzati non eliminava in modo affidabile questi effetti. Strategie di mitigazione differenti hanno interagito diversamente con modelli diversi.
Questa osservazione ha una conseguenza diretta per qualsiasi analisi rigorosa assistita dall'IA: dire a un modello di 'essere imparziale' non equivale a controllare i bias.
Il framing va oltre la scelta delle parole
Gli effetti di framing con l'impatto maggiore spesso non risiedono nelle singole parole, ma sono incorporati nella struttura logica della richiesta.
Consideriamo la differenza tra queste domande:
Quali prove supportano una trasmissione storica tra la tradizione A e la tradizione B?
e:
Quale relazione, se presente, tra la tradizione A e la tradizione B è meglio supportata dalle prove disponibili?
La prima formulazione presuppone già che l'ipotesi di una trasmissione meriti l'attenzione del modello, richiedendo prove all'interno di tale ipotesi. La seconda formulazione permette a trasmissione diretta, influenza indiretta, convergenza, interpretazione retrospettiva o assenza di relazioni dimostrabili di competere prima che venga scelta una conclusione.
Il corpus fattuale potrebbe essere identico. Lo spazio di ricerca non lo è.
Questa distinzione si estende ben oltre la ricerca storica.
- Debugging: 'Perché nginx sta causando questo timeout?' inquadra nginx come causa primaria prima che siano state verificate cause alternative.
- Architettura: 'Come dovremmo implementare questo usando i microservizi?' può eludere la domanda più fondamentale, ovvero se i microservizi siano giustificati.
- Strategia di prodotto: 'Come dovremmo lanciare questo prodotto?' presuppone che il lancio sia l'azione corretta in questo momento.
- Sicurezza: 'In che modo l'aggressore è entrato tramite l'API?' può vincolare l'indagine a un percorso di attacco non ancora accertato.
- Ricerca: 'Cosa spiega questa correlazione?' può favorire narrazioni causali anche quando le prove disponibili dimostrano solo un'associazione.
Un modello sofisticato può notare e mettere in discussione questi presupposti. Ma la metodologia non può dipendere dalla speranza che lo faccia sempre.
Il rispetto delle istruzioni crea una tensione strutturale
I moderni assistenti IA sono intenzionalmente addestrati a seguire le istruzioni. Questa capacità è uno dei motivi per cui sono utili.
Tuttavia, il rispetto delle istruzioni introduce un'importante tensione nel lavoro analitico.
Ci si aspetta contemporaneamente che il modello rispetti la definizione del compito fornita dall'utente e che ragioni in modo indipendente sul fatto che tale definizione contenga o meno presupposti discutibili.
Questi obiettivi sono solitamente compatibili. A volte non lo sono.
Se un utente dice: 'Mostrami perché l'architettura A è superiore all'architettura B', una risposta altamente accondiscendente può produrre un'argomentazione persuasiva a favore di A. Tale risposta può soddisfare perfettamente l'istruzione, omettendo tuttavia di stabilire se A sia effettivamente superiore in base ai vincoli pertinenti.
Ecco perché il prompting metodologico deve distinguere tra eseguire un compito argomentativo assegnato e determinare quale conclusione sia meglio supportata.
La prima è una capacità legittima dell'IA. Non deve essere confusa con la seconda.
La sicofantia è correlata, ma non è lo stesso problema
Il bias indotto dal prompt viene talvolta discusso insieme alla sicofantia. I concetti si sovrappongono, ma non devono essere confusi o ridotti a uno solo.
Gli effetti di framing descrivono cambiamenti nell'output causati dalle caratteristiche con cui viene presentato un compito. La sicofantia si riferisce più nello specifico al comportamento del modello che asseconda, convalida o concorda eccessivamente con la posizione, le preferenze o le convinzioni espresse dall'utente.
Un effetto di framing può verificarsi senza che sia presente alcuna opinione dell'utente. L'ordine delle opzioni da solo può influenzare un risultato. Al contrario, la sicofantia diventa rilevante quando è la posizione stessa dell'utente a influenzare la risposta.
Uno studio di Sharma e colleghi ha riscontrato comportamenti sicofantici in molteplici assistenti IA e ha evidenziato che le risposte corrispondenti alle opinioni espresse dall'utente potevano ricevere segnali di preferenza umana più forti, anche quando tali risposte erano meno veritiere.
La questione non è puramente teorica. Nell'aprile 2025, OpenAI ha ritirato pubblicamente un aggiornamento di GPT-4o dopo aver identificato un comportamento descritto come eccessivamente lusinghiero o accomodante. L'azienda ha dichiarato che i tentativi di migliorare l'intuitività e l'efficacia avevano prodotto un aumento indesiderato della sicofantia.
Una successiva valutazione congiunta sull'allineamento condotta da Anthropic e OpenAI ha inoltre riportato forme note di sicofantia nei modelli valutati di entrambe le organizzazioni.
Questi risultati non devono essere interpretati come una prova del fatto che gli assistenti IA concordino sempre con i loro utenti. Dimostrano invece che l'allineamento compiacente con l'utente è un reale problema di comportamento del modello che richiede una valutazione esplicita.
L'utente può diventare parte dell'ipotesi
Il problema diventa particolarmente sottile nelle lunghe conversazioni analitiche.
Nel corso di più scambi, l'utente può rivelare ciò che si aspetta di trovare, quali spiegazioni ritiene plausibili, a quali prove attribuisce valore e quale conclusione preferisce al momento. Questo contesto è utile. Può migliorare notevolmente la pertinenza del lavoro svolto dal modello.
Ma significa anche che il modello non sta più valutando soltanto il problema esterno. Sta valutando il problema all'interno di un ambiente conversazionale che racchiude le aspettative del ricercatore.
In effetti, l'ipotesi dell'utente può entrare a far parte della distribuzione di input del modello.
Ciò non rende la personalizzazione indesiderabile. Significa che la personalizzazione e la verifica indipendente rispondono a scopi diversi e talvolta dovrebbero essere separate.
Il problema non si risolve chiedendo al modello di dissentire
Una reazione spontanea è quella di aggiungere istruzioni come:
Non essere d'accordo con me. Sii critico. Metti in discussione i miei presupposti.
Queste istruzioni possono rivelarsi utili, ma non risolvono la questione metodologica.
Un dissenso cieco non ha un valore epistemico superiore a quello di un consenso cieco. Un modello ottimizzato per contraddire l'utente può semplicemente introdurre il bias opposto.
L'obiettivo non è il dissenso.
L'obiettivo è l'indipendenza delle conclusioni: devono essere le prove a determinare se l'ipotesi dell'utente viene rafforzata, indebolita, sostituita o lasciata irrisolta.
Ciò richiede un processo in cui le spiegazioni alternative vengano formulate perché plausibili, non perché al modello sia stato chiesto di assumere un atteggiamento antagonistico.
Il bias del prompt e il bias di conferma possono rafforzarsi a vicenda
L'inquadramento del prompt assume implicazioni più profonde quando entra in interazione con un altro problema di ragionamento: il bias di conferma.
Uno studio del 2026 condotto da Jhaveri e colleghi ha valutato undici modelli linguistici impiegando compiti interattivi di scoperta di regole. I modelli hanno frequentemente proposto test intesi a confermare la propria ipotesi iniziale anziché prove in grado di falsificarla. Interventi espliciti mirati a sollecitare controesempi hanno ridotto tale comportamento, aumentando il rendimento medio nella scoperta delle regole negli esperimenti documentati.
Ciò dà origine a un circuito che rischia di autoalimentarsi:
Framing dell'utente → ipotesi iniziale del modello → ricerca di prove a conferma → maggiore convinzione nell'ipotesi inquadrata
È importante sottolineare che ogni singolo passaggio può sembrare ragionevole. La debolezza risiede nella struttura del processo.
Per questo motivo, il livello metodologico successivo non può limitarsi a chiedere al modello di produrre più prove. Deve modificare il modo in cui vengono gestite le ipotesi concorrenti e le prove contrarie.
Questo meccanismo viene sviluppato separatamente in Falsificazione per il ragionamento dell'IA: dalle risposte alle ipotesi verificate.
Perché un ragionamento maggiore non elimina automaticamente il problema
Si è tentati di presumere che modelli di ragionamento più avanzati finiscano per eliminare la dipendenza dal prompt elaborandola a livello logico.
Questa ipotesi non è sicura.
Una maggiore capacità di ragionamento può aiutare un modello a identificare i presupposti, confrontare le spiegazioni e rilevare le contraddizioni. Tuttavia, il modello riceve comunque il prompt come parte delle informazioni che definiscono il compito. Un ragionamento più abile non fa scomparire la formulazione del compito.
Un modello più avanzato può quindi produrre un'analisi più sofisticata pur rimanendo influenzato dall'inquadramento originario.
La profondità del ragionamento e l'indipendenza dall'inquadramento sono proprietà distinte.
Questo è uno dei motivi per cui una struttura metodologica esterna mantiene il suo valore anche quando il modello sottostante diventa più capace.
Il prompt dovrebbe diventare una variabile verificabile
Una volta riconosciuto il prompt come parte dell'ambiente di ragionamento, diventa possibile un importante cambiamento metodologico.
Invece di considerare un unico prompt formulato con cura come la rappresentazione definitiva del problema, possiamo trattare la formulazione stessa come una variabile.
Per compiti a basso impatto, questo non è necessario. Per la ricerca, le diagnosi complesse, l'architettura tecnica, l'analisi strategica e altri compiti in cui le conclusioni contano, molteplici formulazioni legittime possono rivelare dipendenze che un singolo prompt nasconde.
Ciò non significa generare parafrasi casuali. Un test utile modifica presupposti significativi preservando al contempo le prove sottostanti e la domanda di ricerca.
Per esempio:
- rimuovere dalla formulazione la spiegazione preferita dall'utente;
- invertire l'ipotesi iniziale;
- presentare le ipotesi concorrenti in modo simmetrico;
- modificare l'ordine delle opzioni laddove l'ordine dovrebbe essere irrilevante;
- separare la raccolta delle prove dall'interpretazione;
- richiedere un passaggio separato per costruire la più solida obiezione basata sulle prove.
L'obiettivo è osservare cosa cambia — e, soprattutto, cosa non cambia.
Questo conduce direttamente al prossimo articolo della serie: Prompt Invariance: Does the Conclusion Survive the Prompt?.
Da prompt migliori a una metodologia migliore
Il prompt engineering rimane utile. Obiettivi chiari, un buon contesto, vincoli espliciti e formati di output ben progettati migliorano i sistemi di IA.
L'errore sta nel presumere che l'ottimizzazione dei prompt e la validazione del ragionamento siano la stessa disciplina.
Risolvono problemi diversi.
Il prompt engineering si chiede: come dovrei formulare il compito affinché il modello lo esegua bene? Il ragionamento metodologico aggiunge: come faccio a sapere che la conclusione non sia un artefatto del modo in cui ho formulato il compito?
La seconda domanda è ciò che trasforma il prompting da tecnica di interfaccia a parte integrante di una metodologia epistemica.
Il prompt continua a contare. Ma perde la sua posizione privilegiata di punto di partenza indiscusso.
Diventa qualcosa che può essere a sua volta esaminato, variato e testato.
Contesto di ricerca
Diverse direzioni di ricerca indipendenti motivano la distinzione operata in questo articolo. Brucks e Toubia dimostrano sperimentalmente che l'architettura dei prompt può introdurre artefatti metodologici sistematici attraverso l'ordine delle risposte, le etichette, il framing e la giustificazione. Sharma e colleghi esaminano l'adulazione (sycophancy) e il ruolo dei segnali di preferenza umana nel premiare la concordanza con le convinzioni dell'utente. Il rollback di GPT-4o di OpenAI nel 2025 offre un esempio in produzione di compiacenza eccessiva divenuta sufficientemente marcata da richiedere un intervento sul comportamento del modello. La ricerca sul bias di conferma mostra inoltre che i modelli linguistici possono preferire test che confermano l'ipotesi a meno che il processo di ragionamento non incentivi esplicitamente la smentita.
Questi risultati affrontano fenomeni diversi e non dovrebbero essere trattati come prove intercambiabili di un unico meccanismo universale di bias. Insieme, tuttavia, supportano una conclusione metodologica più mirata: l'output dell'IA può dipendere in modo sostanziale da come vengono presentati il compito e la posizione dell'utente, pertanto un singolo prompt non dovrebbe essere automaticamente considerato uno strumento di misurazione neutrale.
Riferimenti selezionati
- Brucks, M. & Toubia, O. — Prompt architecture induces methodological artifacts in large language models. PLOS ONE 20(4), e0319159, 2025.
- Sharma, M. et al. — Towards Understanding Sycophancy in Language Models. arXiv:2310.13548.
- OpenAI — Sycophancy in GPT-4o: What Happened and What We're Doing About It, Aprile 2025.
- Anthropic — Findings from a Pilot Anthropic–OpenAI Alignment Evaluation Exercise, 2025.
- Jhaveri, A. R., GX-Chen, A., Sucholutsky, I. & Choi, E. — Failing to Falsify: Evaluating and Mitigating Confirmation Bias in Language Models. arXiv:2604.02485, 2026.
Continua la serie
- Beyond Prompt Engineering: A Methodology for More Reliable AI Reasoning — il framework metodologico alla base di questa serie.
- Prompt Invariance: Does the Conclusion Survive the Prompt? — verificare se le conclusioni rimangono stabili sotto formulazioni cieche, invertite e avversarie.
- Falsification for AI Reasoning: From Answers to Tested Hypotheses — sostituire il ragionamento confermativo con ipotesi concorrenti e test di smentita.
- From Research Protocol to General AI Reasoning Framework — generalizzare la metodologia tra ricerca, software, debugging e analisi strategica.
Related Articles
Comprehensive Guide to Test Dev Enterprise Stajic.de: Architecture and Best Practices
Explore the architectural principles, benefits, and technical details of managing an enterprise-grade development and testing environment with Test DEv Enterprise Stajic.de.
Tecniche per la creazione di hash di password SHA512 con doveadm
Dettagliata guida per la generazione sicura di hash di password SHA512 dalla riga di comando utilizzando lo strumento doveadm di Dovecot. Questo articolo si rivolge a amministratori del sistema e sviluppatori.
Sviluppo Front-end e Backend
Lo sviluppo front-end e back-end è una parte essenziale dello sviluppo web e comporta la creazione di applicazioni web e siti web. Lo sviluppo front-end si concentra sull'interfaccia utente, mentre lo sviluppo back-end è responsabile della programmazione e della gestione del lato server.
Recensione del router 5G OpenWrt ZBT Z8102AX: Dual SIM, RM500U-EA e una valutazione onesta
Lo ZBT Z8102AX è un insolito router 5G con una base OpenWrt, un concetto dual-SIM e un modem Quectel RM500U-EA. Nei test, mostra chiari punti di forza nella flessibilità, nelle interfacce e nella connettività mobile, ma anche i tipici punti deboli di una build OpenWrt modificata dal produttore.
Rimuovi fonti di pacchetti APT duplicate: Guida per esperti per Ubuntu e Debian
Una guida dettagliata per l'identificazione e la rimozione di fonti ridondanti o duplicate di pacchetti APT in sistemi Debian e Ubuntu, per garantire stabilità e prestazioni.
Guida Completa alle Metriche per la Consegna e la Gestione del Cambiamento
Questa guida fornisce una panoramica dettagliata delle metriche essenziali per la delivery aziendale e la gestione del cambiamento, aiutando i team a misurare le prestazioni, ottimizzare i processi e promuovere il miglioramento continuo. Scopri gli indicatori chiave, i metodi di calcolo e le best practice per allineare le tue metriche ai risultati aziendali.
Recensione hardware e confezione di ZBT Z8102AX: router forte, scatola debole
Lo ZBT Z8102AX fa una solida prima impressione come router OpenWrt 5G sottile in metallo nero con molteplici connettori per antenna, slot dual-SIM, porte USB, LAN/WAN e un pratico set di accessori. L'hardware sembra utile e serio, ma la confezione è chiaramente il punto debole.
Pacchetti Snap: Perché non sono all'altezza per strumenti avanzati come DBeaver
I pacchetti Snap introducono un sandboxing restrittivo che interrompe i flussi di lavoro avanzati. Questo articolo spiega perché DBeaver ha difficoltà con il tunneling SSH sotto Snap e perché Flatpak o i pacchetti nativi sono alternative migliori.
How to Scan and Clean Your Cloud Linux Server from Malware
Architettura Multi-Tenant di Livello Enterprise per una Piattaforma Internazionale
Loving Rocks è una piattaforma per matrimoni di livello enterprise progettata con una vera architettura multi-tenant, database isolati per tenant e internazionalizzazione integrata per scalabilità globale, sicurezza e stabilità operativa a lungo termine.
entdecke-die-bahnbrechenden-moeglichkeiten-von-gpt-4
Google I/O 2026: Prodotti agentici su Search, Workspace e Shopping
Google I/O 2026 ha mostrato che l'IA agentica sta andando oltre le demo dei modelli e gli strumenti per sviluppatori, entrando nelle superfici dei prodotti di tutti i giorni. Questo articolo analizza come Ricerca, Workspace, Gemini Spark e Universal Cart puntino verso un nuovo modello di prodotto in cui gli agenti di Google aiutano gli utenti a fare ricerche, lavorare, fare acquisti e agire attraverso i servizi connessi.