
Oltre l'ingegneria dei prompt: una metodologia per un ragionamento AI più affidabile
L'ingegneria dei prompt è solitamente considerata l'arte di porre domande migliori a un modello. Questo è utile, ma affronta solo una parte del problema. Un prompt ben scritto può migliorare la pertinenza, la struttura e la conformità al compito senza rendere la conclusione risultante epistemicamente solida.
Il problema più profondo è che un modello linguistico di grandi dimensioni non ragiona indipendentemente dal prompt che lo attiva. La formulazione, l'inquadramento, l'ordine, le assunzioni incorporate nella richiesta e la posizione esplicitamente dichiarata dall'utente possono tutti influenzare quali parti della conoscenza interna del modello diventano dominanti nella risposta generata.
Ciò significa che migliorare il ragionamento dell'IA richiede più di istruzioni migliori. Richiede una metodologia che tratti il prompt stesso come una potenziale fonte di bias e sottoponga la conclusione del modello a una verifica strutturata.
L'obiettivo non è rendere il modello più intelligente. L'obiettivo è utilizzare l'intelligenza già disponibile in modo più rigoroso.
Capacità non è la stessa cosa di disciplina di ragionamento
I moderni modelli di ragionamento possono scomporre compiti complessi, confrontare alternative, esaminare prove, identificare contraddizioni e rivedere conclusioni. Ma avere queste capacità non implica che ogni risposta le utilizzerà automaticamente tutte.
Un assistente IA general-purpose deve operare su compiti e utenti radicalmente diversi. Un utente vuole un calcolo. Un altro vuole che un breve messaggio venga riscritto. Un altro ancora vuole il debug di un software. Un altro si aspetta un'indagine storica o scientifica. Applicare un protocollo massimale di verifica delle ipotesi a ogni richiesta aumenterebbe frequentemente latenza, verbosità e carico cognitivo senza migliorare l'effettiva utilità della risposta.
Di conseguenza, la domanda centrale non è semplicemente se un modello può eseguire un ragionamento rigoroso. La domanda più importante è in quali condizioni tale capacità viene sistematicamente attivata, messa alla prova e verificata.
Il prompt non è un'interfaccia neutrale
La ricerca ha ripetutamente dimostrato che caratteristiche apparentemente secondarie dei prompt possono influenzare gli output del modello. L'ordine dei prompt, le etichette, l'inquadramento e le richieste di giustificazione hanno tutti dimostrato di produrre artefatti metodologici misurabili. Ricerche separate sulla sycophancy hanno mostrato che i modelli linguistici possono talvolta adattare le loro risposte verso le posizioni espresse dall'utente invece di mantenere una valutazione completamente indipendente.
Ciò non significa che ogni modello si limiti ad essere d'accordo con il suo utente, né che ogni prompt contamini ogni conclusione. Significa qualcosa di più preciso: il prompt fa parte dell'ambiente di inferenza. Pertanto, una conclusione ottenuta sotto un inquadramento non può essere automaticamente assunta come invariante sotto un altro.
Le conseguenze di tale distinzione sono esaminate separatamente in Il prompt è parte del bias, dove l'inquadramento del prompt, il rispetto delle istruzioni e il comportamento di accordo del modello sono trattati come un problema metodologico piuttosto che semplicemente un problema di prompting.
Dall'ingegneria dei prompt a un processo epistemico
L'ingegneria tradizionale dei prompt ottimizza principalmente l'input. La metodologia qui proposta struttura invece il percorso completo dalla domanda alla conclusione.
Una forma semplificata di tale processo può essere rappresentata come:
Problema → scomposizione → prove → ipotesi concorrenti → controprove → tentativi di falsificazione → sintesi → verifica dell'inquadramento → conclusione calibrata
La differenza importante è che la prima risposta coerente non è più trattata come il punto di arrivo. Diventa una conclusione candidata che deve superare ulteriori test.
1. Separare le prove dall'interpretazione
Il primo requisito è impedire che osservazioni, interpretazioni e assunzioni collassino in un'unica narrazione. Un modello dovrebbe distinguere esplicitamente ciò che è direttamente supportato da ciò che è inferito.
- Evidenza: informazione direttamente supportata da una fonte, osservazione, misurazione, log, documento o risultato riproducibile.
- Interpretazione: una spiegazione derivata dall'evidenza.
- Assunzione: una proposizione attualmente richiesta dal processo di ragionamento ma non ancora stabilita in modo indipendente.
- Domanda aperta: un'incertezza rilevante per la quale le evidenze disponibili sono insufficienti.
Questa separazione è semplice, ma ha una conseguenza importante: l'incertezza diventa visibile prima di essere assorbita nella narrazione finale.
2. Generare Ipotesi Concorrenti
Una spiegazione solida non è stabilita semplicemente perché l'evidenza può essere interpretata a suo favore. Il modello dovrebbe costruire alternative credibili e chiedersi se le stesse evidenze possono essere spiegate anche da esse.
Nella ricerca storica, questo potrebbe significare distinguere trasmissione diretta, trasmissione indiretta, convergenza indipendente e interpretazione retrospettiva. Nel debug del software può significare separare un guasto di rete, un errore di configurazione, un bug dell'applicazione e un guasto di un servizio esterno. Nell'analisi di business può significare confrontare molteplici spiegazioni causali per lo stesso segnale di mercato.
Le etichette cambiano tra le discipline. Il principio metodologico no.
3. Cercare Evidenze Che Potrebbero Far Fallire la Spiegazione Preferita
La conferma è relativamente facile. Data un'ipotesi plausibile, sia gli esseri umani che i modelli linguistici possono spesso trovare fatti che appaiono compatibili con essa. Un test più impegnativo chiede quali evidenze dovrebbero esistere se l'ipotesi fosse vera, quali evidenze non dovrebbero esistere e quale osservazione la indebolirebbe significativamente.
Recenti lavori sperimentali sul bias di conferma nei modelli linguistici supportano l'importanza di questo passo. Quando ai modelli è consentito testare liberamente le ipotesi, possono preferire test di conferma rispetto a quelli di falsificazione. È stato dimostrato che interventi espliciti che incoraggiano controesempi e test di disconferma migliorano la scoperta di ipotesi.
Il ruolo completo della falsificazione e delle contro-evidenze in questa metodologia è sviluppato in Falsificazione per il Ragionamento AI: Dalle Risposte alle Ipotesi Testate.
4. Preservare la Provenienza e la Distanza Causale
Non tutte le informazioni di supporto hanno lo stesso valore probatorio. Un documento primario, un'interpretazione secondaria, una citazione successiva, un riassunto senza fonte e una parafrasi generata da un modello non possono essere trattati come intercambiabili solo perché contengono affermazioni simili.
Un processo rigoroso preserva quindi il percorso tra fonte e conclusione. Ove possibile, la catena di ragionamento dovrebbe rimanere ispezionabile:
Conclusione → interpretazione → evidenza di supporto → fonte
Si possono poi aggiungere validatori specifici per dominio. La ricerca storica richiede cronologia, plausibilità geografica, provenienza e possibili canali di trasmissione. L'architettura software richiede vincoli, compatibilità, prestazioni, manutenibilità e modalità di guasto. L'analisi scientifica richiede progettazione sperimentale, qualità della misurazione, riproducibilità e spiegazioni causali alternative.
5. Verificare Se la Conclusione Sopravvive al Prompt
L'estensione più importante è trattare il prompt stesso come una variabile.
Uso qui il termine invarianza del prompt per un test pratico: la conclusione essenziale rimane stabile quando le stesse prove vengono esaminate sotto inquadramenti del prompt materialmente diversi ma legittimi?
Un'implementazione utile può contenere almeno quattro passaggi:
- Passaggio originale: analizzare il problema come inizialmente formulato.
- Passaggio cieco: rimuovere la spiegazione preferita dall'utente e chiedere quale ipotesi le prove supportano.
- Passaggio invertito: trattare un'ipotesi opposta credibile come proposizione di partenza e verificarla rispetto alle stesse prove.
- Passaggio avversariale: costruire deliberatamente la più forte sfida basata sulle prove alla conclusione attuale.
L'obiettivo non è forzare quattro risposte identiche. Differenze legittime di inquadramento possono esporre assunzioni precedentemente nascoste. Il segnale rilevante è quali risultati fattuali, nessi causali e giudizi di confidenza sopravvivono attraverso le diverse formulazioni.
L'invarianza del prompt non va quindi confusa con la prova fattuale. È meglio intesa come un test di robustezza contro una specifica classe di dipendenza metodologica: l'eccessiva dipendenza dall'inquadramento originale.
Il concetto e i suoi limiti sono sviluppati in dettaglio in Invarianza del Prompt: La Conclusione Sopravvive al Prompt?.
6. Calibrare la Conclusione Invece di Forzare la Certezza
Una metodologia progettata per resistere al bias di conferma deve permettere allo stato finale di rimanere incerto. Il processo è fallito se ogni indagine deve concludersi con un sì o un no sicuro.
I possibili esiti includono forte supporto, supporto moderato, supporto debole, competizione irrisolta tra ipotesi, prove insufficienti o prove incoerenti con la proposizione originale. Il requisito importante è che la confidenza segua la qualità e la struttura delle prove piuttosto che la coerenza retorica della risposta generata.
Un Nucleo Indipendente dal Dominio con Validatori Specifici del Dominio
La metodologia diventa particolarmente visibile nei compiti di ricerca perché la ricerca espone naturalmente problemi di prove, interpretazione e spiegazioni concorrenti. Ma il suo nucleo non è limitato al lavoro storico o accademico.
La stessa struttura generale può essere applicata al debug, all'architettura software, alla strategia di prodotto, alla due diligence tecnica, alla gestione di progetti, all'analisi di sicurezza e ad altri domini in cui una prima risposta plausibile può essere sostanzialmente più debole di una conclusione verificata.
Ciò che cambia è il livello di validazione. Il nucleo epistemico rimane in gran parte stabile mentre ogni dominio fornisce le proprie regole per determinare cosa costituisce una prova forte, un meccanismo causale plausibile o un test di falsificazione significativo.
Questa transizione da protocollo di ricerca a framework di ragionamento riutilizzabile è l'oggetto di Da Protocollo di Ricerca a Framework Generale di Ragionamento AI.
Perché un Modello di Ragionamento Non Applica Automaticamente il Metodo Completo
Sarebbe allettante concludere che modelli di ragionamento sufficientemente avanzati dovrebbero rendere questa metodologia superflua. Tale conclusione confonde la capacità con il comportamento predefinito.
Un assistente generale non ha una ragione universale per massimizzare la verifica epistemica per ogni richiesta. Gli utenti differiscono in competenza, obiettivi, tempo disponibile, profondità desiderata e tolleranza alla complessità. Anche i compiti differiscono radicalmente nel costo di un errore.
Per molte richieste, una risposta diretta è il comportamento di prodotto corretto. Per altre, specialmente ricerca, architettura, decisioni ad alto impatto e diagnosi tecnica complessa, una verifica aggiuntiva può migliorare sostanzialmente l'affidabilità.
La metodologia agisce quindi come un cambiamento deliberato dell'obiettivo di ragionamento. Invece di ottimizzare principalmente per una risposta utile e coerente, attribuisce un peso aggiuntivo alla robustezza epistemica, alla tracciabilità e alla resistenza all'inquadramento iniziale dell'utente.
Dalla metodologia a un livello di verifica epistemica
Una volta espressa come processo ripetibile, la metodologia non deve più esistere solo come una lunga istruzione posta davanti a un modello linguistico. Può diventare parte di un'architettura di IA.
Agenti diversi o passaggi di inferenza possono generare ipotesi, cercare prove contraddittorie, valutare le fonti, eseguire una revisione adversarial e confrontare i risultati tra varianti di prompt. La risposta finale può quindi essere prodotta dallo stato intermedio verificato anziché direttamente dalla richiesta originale dell'utente.
Prompt → scomposizione → spiegazioni candidate → prove → contestazione → verifica → sintesi → risposta
Questa architettura e il suo rapporto con agenti, sistemi di recupero e inferenza multi-passaggio sono sviluppati in Progettare un livello di verifica epistemica per gli LLM.
Ciò che questa metodologia non pretende
Una metodologia rigorosa dovrebbe anche definire i propri limiti.
- Non garantisce che il modello possieda le conoscenze necessarie.
- Non rende più forti le prove deboli o mancanti.
- Non elimina le allucinazioni, gli effetti di inquadramento o i pregiudizi del modello.
- Non dimostra che una conclusione sia vera semplicemente perché diverse varianti di prompt l'hanno prodotta.
- Non sostituisce la competenza di dominio, le fonti primarie, gli esperimenti o la verifica esterna dove questi sono richiesti.
- Aumenta il lavoro computazionale, l'uso di token e la latenza.
- Il suo scopo è rendere errori, assunzioni e dipendenze più facili da esporre prima che diventino conclusioni.
Il principio centrale
L'ingegneria dei prompt chiede come ottenere una risposta migliore da un modello.
La metodologia qui descritta pone una domanda diversa:
A quale processo dovrebbe sopravvivere una conclusione dell'IA prima che decidiamo che la risposta è abbastanza buona da essere considerata affidabile?
Questo cambiamento di prospettiva è fondamentale. Sposta l'attenzione dall'ottimizzazione di un singolo prompt al controllo del processo di ragionamento che lo circonda.
Il prompt rimane importante, ma non è più trattato come un punto di partenza indiscutibile. Diventa un input in un processo che può ispezionare le sue assunzioni, contestare il suo inquadramento e verificare se la conclusione risultante sopravvive a interpretazioni alternative.
In termini pratici, la metodologia non tenta di creare un modello più intelligente. Tenta di creare un uso più disciplinato delle capacità esistenti del modello.
Contesto di ricerca
La proposta metodologica in questo articolo è informata da diverse aree correlate della ricerca attuale sui LLM. Sharma et al. hanno esaminato il comportamento adulatorio negli assistenti AI e la relazione tra i segnali di preferenza umana e l'accordo con le convinzioni dell'utente. Brucks e Toubia hanno dimostrato che l'architettura del prompt — inclusi ordine, etichette, inquadramento e giustificazione — può creare artefatti metodologici sistematici nelle risposte del modello. Jhaveri et al. hanno esaminato sperimentalmente il bias di conferma durante l'esplorazione di ipotesi e hanno scoperto che gli interventi che incoraggiano controesempi riducono il comportamento confermatorio e migliorano la scoperta di regole.
Questi studi non stabiliscono la metodologia completa qui proposta, né costituiscono una prova che l'invarianza del prompt sia una metrica di validazione standardizzata. Essi stabiliscono risultati empirici più ristretti che motivano la necessità di un controllo più esplicito su inquadramento, verifica delle ipotesi e verifica.
Riferimenti selezionati
- Sharma, M. et al. — Towards Understanding Sycophancy in Language Models. arXiv:2310.13548, pubblicato originariamente nel 2023; rivisto nel 2025.
- Brucks, M. S. & Toubia, O. — Prompt architecture induces methodological artifacts in large language models. PLOS ONE, 2025.
- Jhaveri, A. R., GX-Chen, A., Sucholutsky, I. & Choi, E. — Failing to Falsify: Evaluating and Mitigating Confirmation Bias in Language Models. arXiv, 2026.
Continua la serie
- Il prompt è parte del bias — come inquadramento, istruzioni e presupposti dell'utente influenzano il ragionamento del modello.
- Invarianza del prompt: la conclusione sopravvive al prompt? — un test di robustezza pratico utilizzando formulazioni cieche, invertite e avversariali.
- Falsificazione per il ragionamento AI: dalle risposte alle ipotesi testate — controevidenza, ipotesi concorrenti e test di disconferma.
- Dal protocollo di ricerca a un framework generale di ragionamento AI — applicare la metodologia oltre la ricerca storica.
- AI nel gaming: ragionamento applicato in condizioni di informazione incerta — una prospettiva applicata da figure.rocks.
Related Articles
Cosa dovrebbe ricordare, dimenticare, ricalcolare o recuperare di nuovo un agente IA?
Gli agenti a lunga esecuzione non dovrebbero ricordare tutto. Questo articolo fornisce un modello pratico di ciclo di vita per decidere cosa appartiene alla memoria durevole, cosa dovrebbe essere recuperato di nuovo, cosa è più sicuro ricalcolare e cosa dovrebbe scadere o essere sostituito.
Guida Completa ai Trigger di Rollback nei Runbook AI Aziendali
Questa guida esplora i Rollback Trigger, meccanismi essenziali nei runbook AI aziendali che rilevano automaticamente le anomalie e avviano rollback per mantenere la stabilità del sistema. Scopri come configurare, monitorare e ottimizzare questi trigger per distribuzioni AI robuste.
Perché più contesto può peggiorare le risposte dell'IA
Una finestra di contesto più ampia non garantisce una risposta migliore. Questo articolo spiega come la diluizione del segnale, le prove contrastanti, lo stato obsoleto, la sensibilità alla posizione e la compressione con perdita possano ridurre l'affidabilità dell'IA—e introduce un pratico Context Pressure Test.
Che cos'è un architetto di piattaforme AI? Modelli, dati, runtime, sicurezza e operazioni
Un Architetto di Piattaforme AI progetta fondamenta AI riutilizzabili attraverso modelli, fornitori, recupero, agenti, identità, sicurezza, valutazione, osservabilità e operazioni.
MLOps vs LLMOps: cosa cambia quando il modello è un LLM
MLOps gestisce i sistemi di machine learning; LLMOps estende tali pratiche a prompt, contesto, recupero, provider, strumenti, valutazioni e comportamento a runtime attorno ai modelli linguistici di grandi dimensioni.
Tendenze emergenti di Linux nel 2026: plasmare il futuro dell'infrastruttura server
Esplora le principali tendenze Linux del 2026, dal dominio di Kubernetes e dalle distribuzioni immutabili all'integrazione dell'IA e alla sicurezza eBPF.
Google I/O 2026: Svolte architetturali, IA agentica e l'esame di realtà dell'ecosistema unificato
Google I/O 2026 non è stato solo un evento dedicato ai modelli. Ha mostrato un cambiamento di piattaforma più profondo che attraversa i modelli Gemini, gli strumenti per sviluppatori, le superfici collegate ad Android e i dispositivi intelligenti. Questo articolo analizza il keynote come punto di riferimento per ingegneri, architetti e team di prodotto che hanno bisogno di separare le reali implicazioni di runtime dall'hype da palcoscenico.
Quando dovrebbe un'IA smettere di fidarsi della propria conoscenza? — Il grilletto del recupero
Un modello di IA non necessita del recupero per ogni domanda. Il problema importante è sapere quando la sua conoscenza interna non è più sufficiente. Il Trigger di Recupero è un confine decisionale pratico che determina quando un sistema di IA dovrebbe smettere di affidarsi esclusivamente alla conoscenza del modello e ottenere prove esterne prima di rispondere.
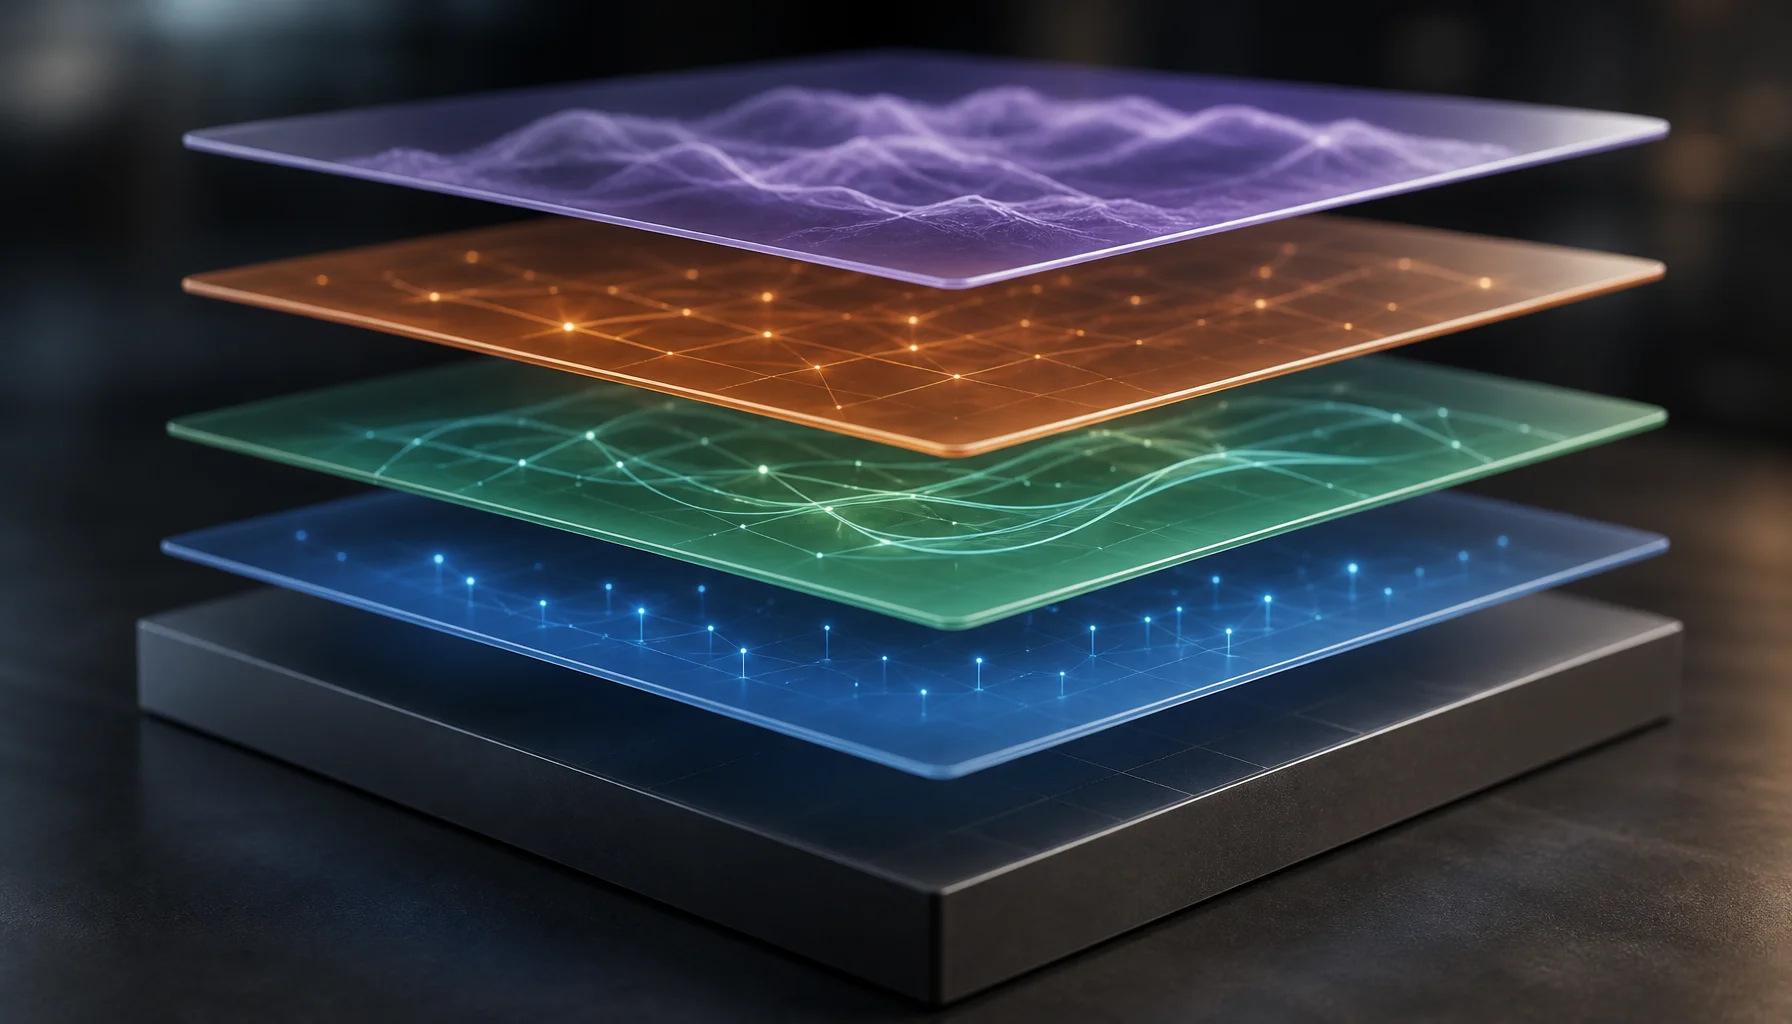
La memoria dell'agente IA non è RAG: come separare memoria, recupero, stato e contesto
Memoria dell'agente, RAG, stato e contesto vengono spesso usati come se fossero intercambiabili. Non lo sono. Questo pratico modello architetturale separa i quattro livelli, mostra dove si colloca ciascuno e spiega cosa si rompe quando i sistemi li fanno collassare in uno solo.
Guida completa a Evaluation Harness: Padroneggiare la valutazione delle prestazioni degli LLM
Questa guida fornisce una panoramica dettagliata di Evaluation Harness, un framework essenziale per valutare rigorosamente le capacità dei modelli linguistici di grandi dimensioni (LLM) nelle pipeline LLMOps aziendali. Scopri la configurazione, le best practice e le tecniche avanzate per garantire un benchmarking e un'ottimizzazione dei modelli affidabili.
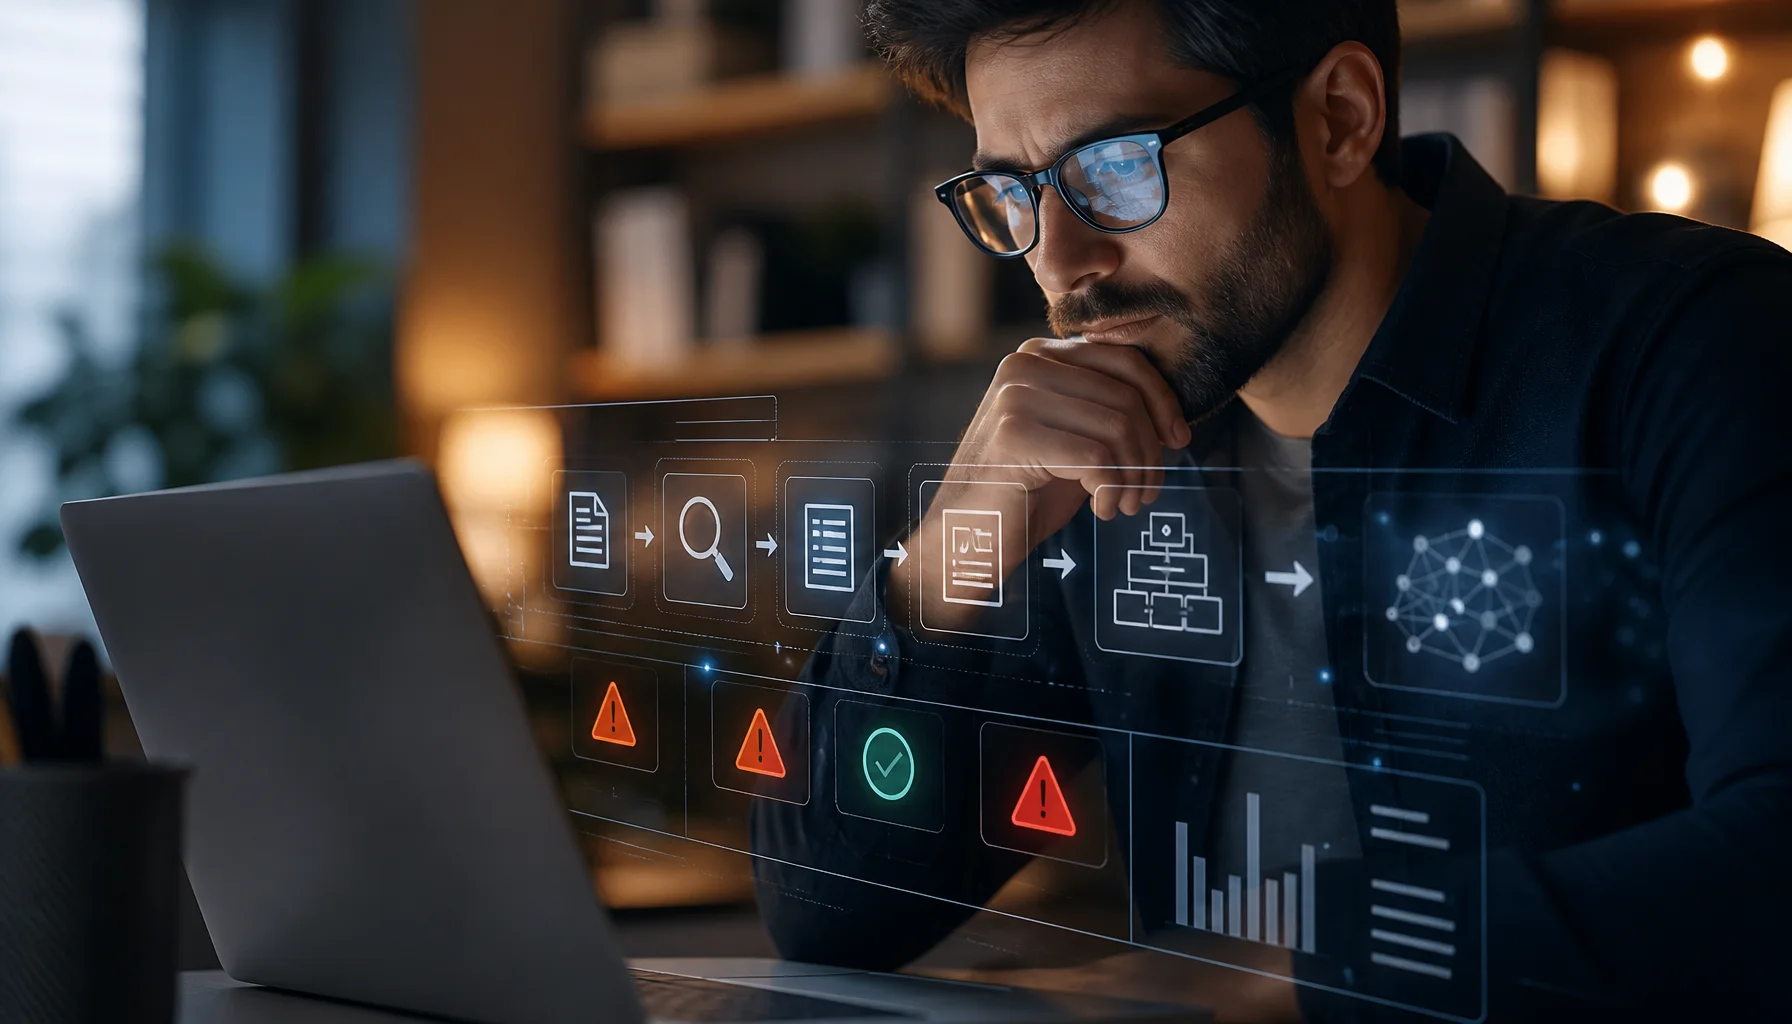
RAG non riuscito — Ma quale livello ha effettivamente fallito? Un metodo diagnostico
Quando una risposta RAG è sbagliata, dare la colpa al recupero o al modello è troppo vago. Questo metodo diagnostico isola la copertura delle fonti, la costruzione della query, il recupero, il ranking, l'assemblaggio del contesto, la generazione, l'attribuzione delle evidenze e l'aggiornamento—così il guasto effettivo può essere riprodotto e corretto.
Guida Completa alle Metriche per la Consegna e la Gestione del Cambiamento
Questa guida fornisce una panoramica dettagliata delle metriche essenziali per la delivery aziendale e la gestione del cambiamento, aiutando i team a misurare le prestazioni, ottimizzare i processi e promuovere il miglioramento continuo. Scopri gli indicatori chiave, i metodi di calcolo e le best practice per allineare le tue metriche ai risultati aziendali.