
Guida Completa ai Trigger di Rollback nei Runbook AI Aziendali
# Guida ai Trigger di Rollback
## Introduzione ai Trigger di Rollback
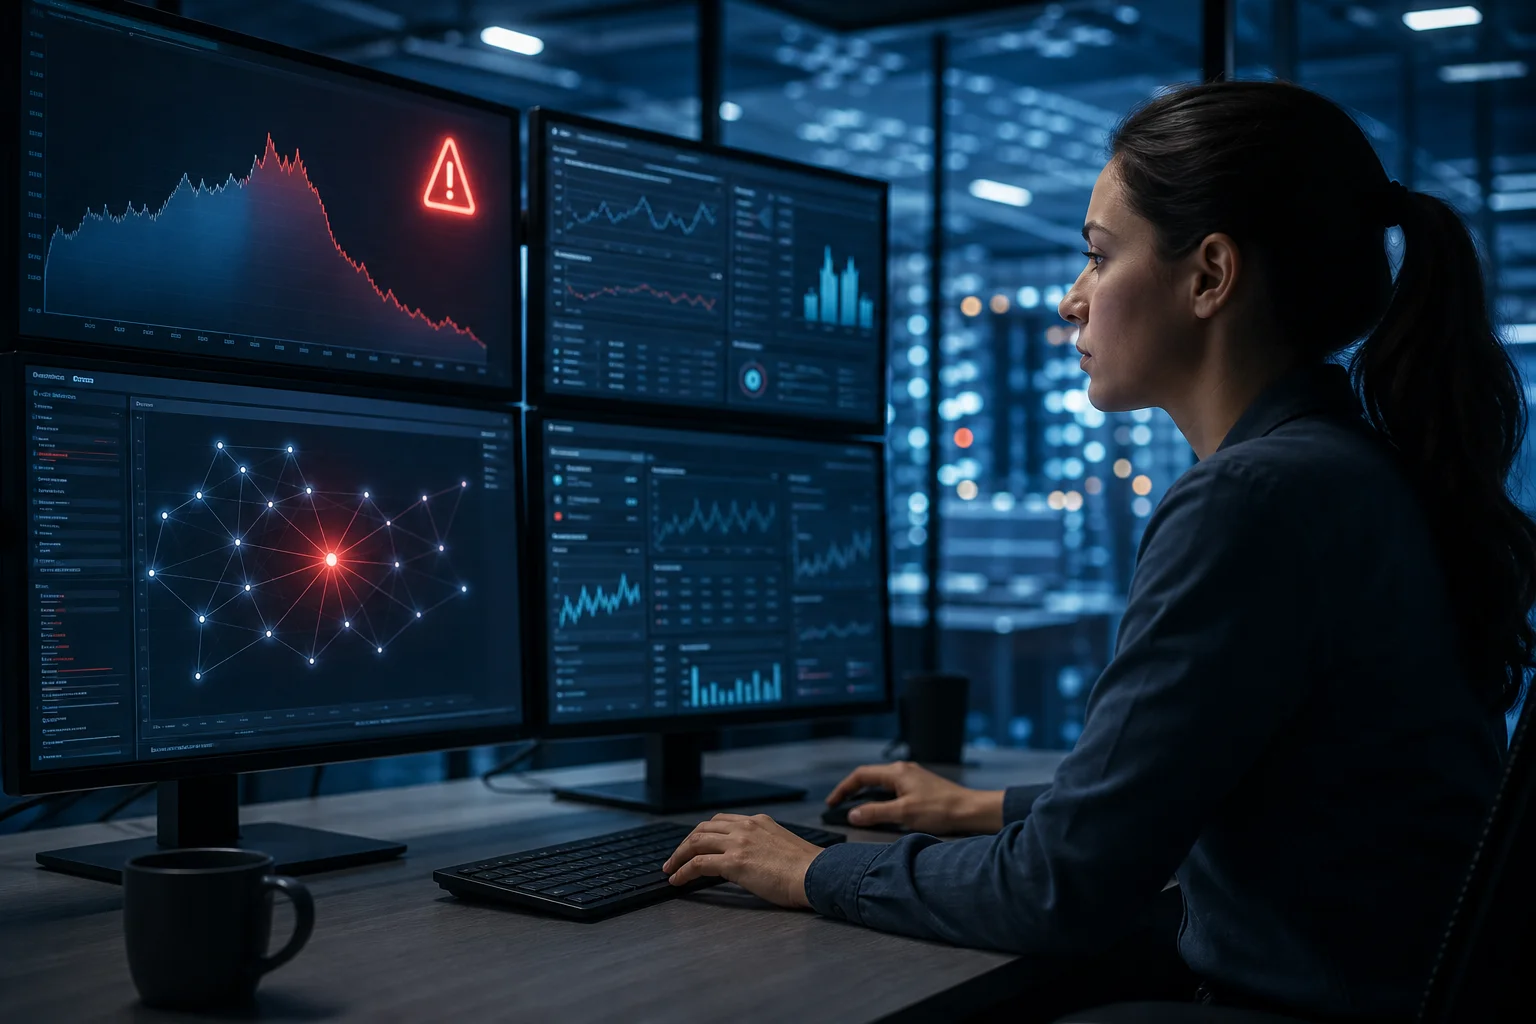
Nei runbook AI aziendali, i Trigger di Rollback fungono da salvaguardie automatizzate che rilevano problemi di deployment e ripristinano una versione stabile precedente. Questi trigger sono fondamentali per ridurre al minimo i tempi di inattività, proteggere l'esperienza utente e garantire la conformità in ambienti AI ad alto rischio. Definendo condizioni precise per il rollback, i team possono rispondere ai guasti in pochi secondi anziché in ore.
I Trigger di Rollback si integrano perfettamente con le pipeline CI/CD, gli strumenti di monitoraggio e le metriche specifiche per l'AI come il model drift o i picchi di latenza di inferenza.
## Principali vantaggi dei Trigger di Rollback
- **Recupero rapido**: Ripristina automaticamente le modifiche entro pochi secondi dal rilevamento dei problemi. - **Riduzione degli errori umani**: Elimina l'intervento manuale in situazioni di panico. - **Garanzia di conformità**: Registra tutti gli eventi dei trigger per le piste di audit. - **Risparmio sui costi**: Previene l'esposizione prolungata a modelli difettosi che comportano elevati costi di calcolo. - **Scalabilità**: Gestisce senza sforzo migliaia di microservizi o varianti di modello.
## Tipi di Trigger di Rollback
### 1. Trigger basati su metriche
Monitora KPI quantitativi come: - Tassi di errore superiori al 5%. - Aumenti di latenza oltre i 200 ms al p95. - Picchi di utilizzo di CPU/memoria oltre il 90%.
### 2. Trigger di rilevamento delle anomalie
Sfrutta il rilevamento delle anomalie basato sull'AI: - Calo improvviso dell'accuratezza del modello. - Pattern di traffico insoliti che indicano fallimenti nei test A/B. - Punteggi di data drift che superano le soglie predefinite.
### 3. Trigger Canary e Blue-Green
Trigger specifici per il deployment: - Fallimento del rollout Canary (es. <80% di istanze sane). - Ritorno al Blue-green in caso di discrepanze nel traffico shadow.
### 4. Trigger manuali ed esterni
- Endpoint API per rollback on-demand. - Integrazione con PagerDuty o Slack per l'override umano.
## Configurazione dei Trigger di Rollback: Passo per passo
### Passo 1: Definisci le condizioni del trigger
Nella configurazione YAML del tuo runbook:
- Imposta soglie: `error_rate > 0.05 for 2m`. - Specifica finestre di valutazione: medie mobili su 5 minuti. - Aggiungi isteresi per evitare flapping: `>5% su, <3% giù`.
### Passo 2: Seleziona l'ambito del rollback
Scegli la granularità: - **Livello modello**: Ripristina versioni specifiche di modelli AI. - **Livello servizio**: Esegui il rollback dell'intero microservizio. - **Livello cluster**: Ripristina deployment Kubernetes.
### Passo 3: Integra il monitoraggio
Collegati a strumenti come Prometheus, Datadog o piattaforme personalizzate di osservabilità AI:
- Esporta metriche tramite l'endpoint `/metrics`. - Definisci alert con query `PromQL`. - Abilita notifiche webhook per sistemi esterni.
### Passo 4: Testa i trigger
- **Modalità Dry-Run**: Simula guasti senza rollback effettivi. - **Chaos Engineering**: Inietta guasti usando strumenti come Gremlin. - **Replay storico**: Testa con dati di incidenti passati.
### Passo 5: Distribuisci e monitora
- Distribuisci tramite GitOps (ArgoCD, Flux). - Configura dashboard per la cronologia dei trigger. - Rivedi i falsi positivi settimanalmente.
## Best practice per trigger di rollback efficaci
- **Logica multi-trigger**: Usa combinazioni AND/OR (es. alto errore E latenza). - **Periodi di grazia**: Consenti 30-60s di warmup dopo il deployment. - **Blocco versione**: Esegui sempre il rollback a versioni note valide, non all'ultima. - **Prevenzione dell'affaticamento da alert**: Raggruppa metriche correlate in trigger compositi. - **Analisi post-rollback**: Genera automaticamente report sugli incidenti.
## Errori comuni e soluzioni
| Errore | Soluzione | |--------|----------| | Falsi positivi | Aumenta la finestra di valutazione e aggiungi più condizioni. | | Rilevamento lento | Usa intervalli di polling inferiori al minuto. | | Rollback incompleti | Verifica il successo del rollback con controlli di salute. | | Trigger troppo aggressivi | Implementa rollback a fasi (50% -> 100%). |
## Funzionalità avanzate
- **Trigger ottimizzati con ML**: Regola automaticamente le soglie usando reinforcement learning. - **Trigger federati**: Coordina rollback su configurazioni multi-cloud. - **Trigger predittivi**: Usa previsioni su serie temporali per prevenire problemi.
## Monitoraggio e manutenzione
Tieni traccia di questi KPI: - Tasso di attivazione dei trigger (obiettivo: <1% dei deployment). - Tempo medio per il rollback (obiettivo: <30s). - Tasso di successo dei rollback (obiettivo: 99.9%).
Esegui audit regolari delle configurazioni durante le revisioni degli sprint.
## Conclusione
I Rollback Triggers trasformano le distribuzioni AI da esperimenti rischiosi in sistemi di produzione affidabili. Definendo e perfezionando proattivamente questi meccanismi, i team enterprise raggiungono una stabilità e una velocità senza precedenti. Inizia con trigger metrici di base ed evolvi verso il rilevamento delle anomalie basato su AI per risultati ottimali.
Related Articles
Da un protocollo di ricerca a un quadro generale di ragionamento per l'IA
Una metodologia sviluppata per una ricerca rigorosa assistita dall'IA può essere generalizzata ben oltre la ricerca stessa. Separando le prove dalle ipotesi, testando ipotesi concorrenti, controllando l'impostazione dei prompt, cercando controprove e applicando validatori specifici del dominio, la stessa architettura di ragionamento può migliorare il debug, la progettazione del software, la strategia, l'analisi tecnica e il supporto decisionale assistito dall'IA.
Quanto dista un'affermazione dell'IA dalle prove? — Distanza probatoria
Non tutte le risposte supportate sono ugualmente vicine alle loro prove. La Distanza dalle Prove è un modo pratico per descrivere quante trasformazioni, sintesi, assunzioni e passaggi inferenziali separano un'affermazione dell'IA da prove direttamente ispezionabili.
MLOps vs LLMOps: cosa cambia quando il modello è un LLM
MLOps gestisce i sistemi di machine learning; LLMOps estende tali pratiche a prompt, contesto, recupero, provider, strumenti, valutazioni e comportamento a runtime attorno ai modelli linguistici di grandi dimensioni.
Database vettoriali, embedding e reranking: tre parti diverse del recupero
Gli embedding rappresentano il significato, i database vettoriali recuperano i candidati e i reranker affinano i risultati. Scopri come questi tre livelli di recupero si differenziano e collaborano nel RAG.
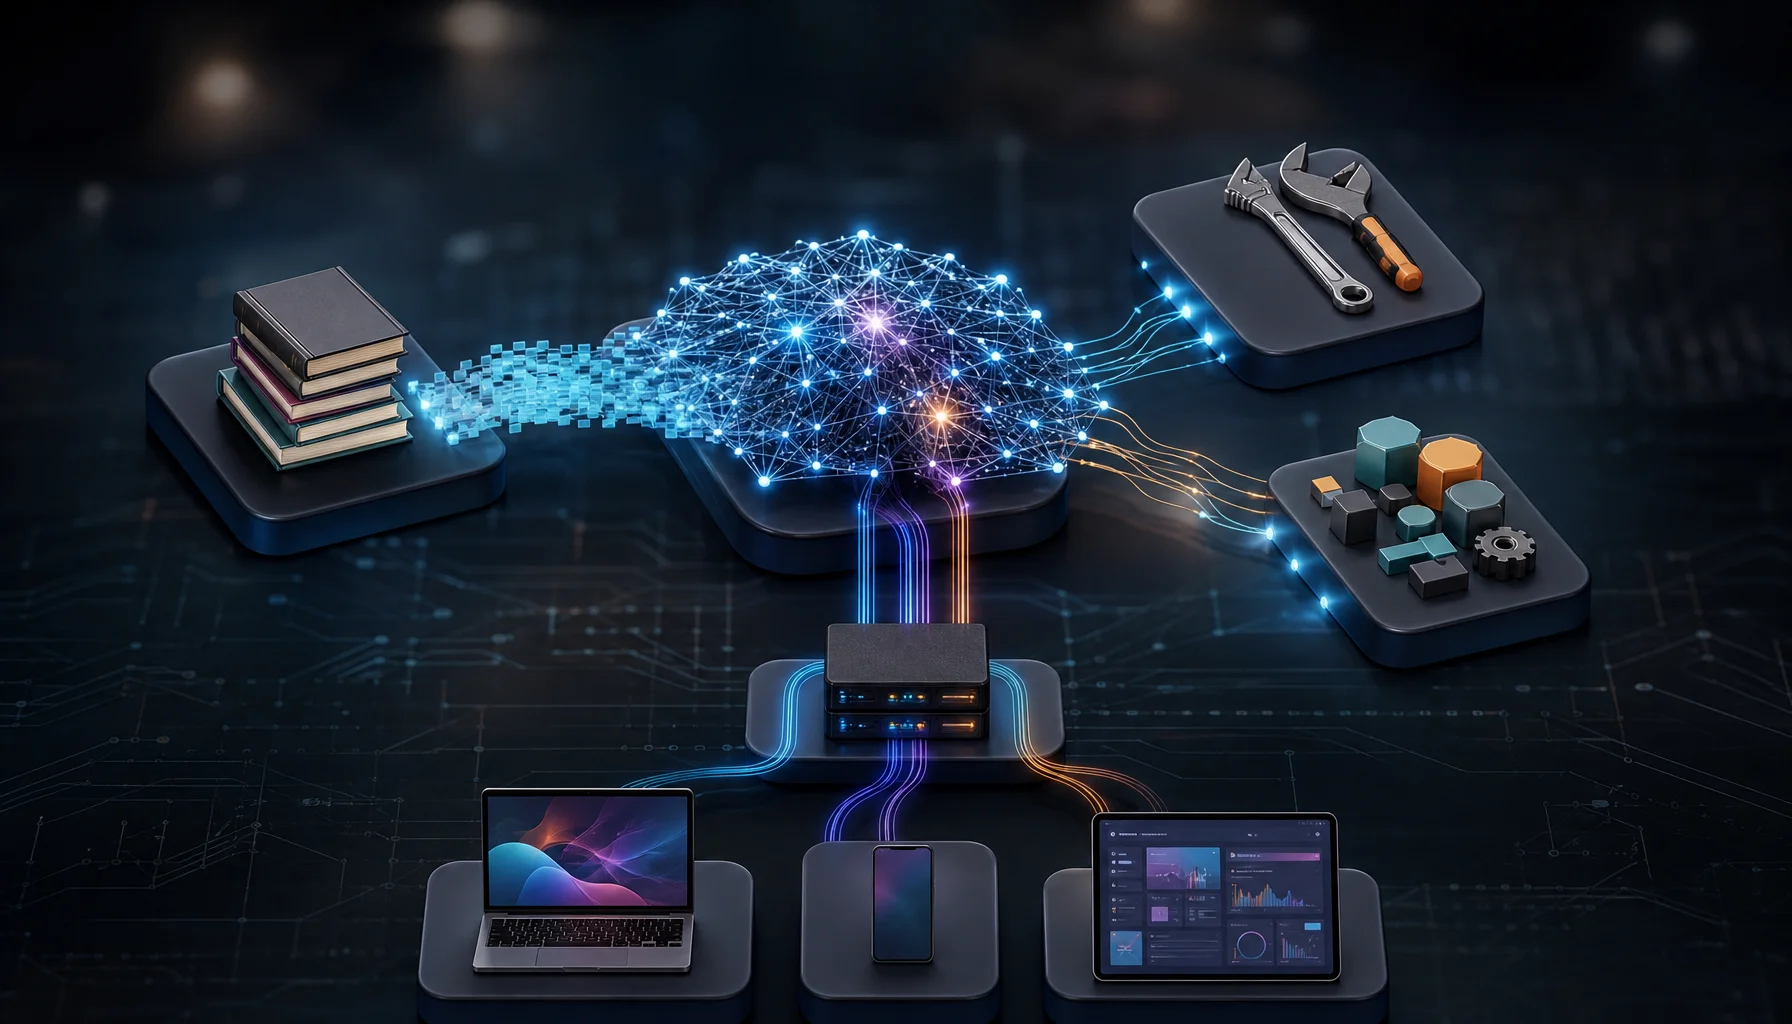
L'IA generativa spiegata: modelli, recupero, strumenti e applicazioni non sono la stessa cosa
L'IA generativa è più di un modello. Scopri come modelli, recupero, strumenti, contesto, runtime e applicazioni si integrano nei sistemi di IA in produzione.
Fonte di verità nei sistemi di IA: da dove proviene realmente la conoscenza affidabile
Una Fonte di Verità definisce quale fonte è autorevole per un fatto o uno stato specifico. Scopri come si differenzia da RAG, provenienza, memoria, contesto, database vettoriali e sistemi di registrazione.
Governance dell'IA: modelli, dati, autorizzazioni, rischio e verificabilità
La governance dell'IA definisce chi può approvare, gestire, modificare e verificare i sistemi di IA attraverso modelli, fornitori, dati, autorizzazioni, rischi, valutazione e l'intero ciclo di vita.
RBAC vs Isolamento dei Tenant: Due Confini di Sicurezza Diversi
Il controllo RBAC stabilisce cosa può fare un utente; l'isolamento dei tenant stabilisce a quali risorse di quale tenant può accedere tale azione. Scopri perché la sicurezza SaaS multi-tenant richiede entrambi i confini.
Guida Definitiva ai Criteri di Accettazione per l'Adozione di LLM nei Playbook Aziendali
Padroneggia l'arte di definire criteri di accettazione precisi per garantire un'integrazione LLM di successo nel tuo ambiente aziendale. Questa guida completa fornisce framework attuabili, esempi e best practice su misura per l'adozione guidata da playbook.
ADR vs NFR: decisioni architetturali e qualità del sistema non sono la stessa cosa
ADR vs NFR spiegati: scopri come i requisiti di qualità del sistema guidano le decisioni architetturali, come gli ADR registrano i compromessi e perché la validazione rimane separata.
IA agentica spiegata: quando un sistema di IA può pianificare, usare strumenti e agire
L'IA agentica utilizza modelli all'interno di cicli di esecuzione a più passaggi, in cui possono scegliere strumenti, osservare i risultati, aggiornare lo stato e adattare l'azione successiva entro limiti espliciti di runtime e di autorizzazione.
Oltre l'ingegneria dei prompt: una metodologia per un ragionamento AI più affidabile
I grandi modelli linguistici non falliscono necessariamente perché mancano di capacità di ragionamento. Spesso falliscono perché il processo di ragionamento non è sufficientemente vincolato, messo in discussione o verificato. Questo articolo presenta una metodologia indipendente dal dominio che trasforma il prompting in un processo epistemico strutturato: separare i fatti dalle assunzioni, generare ipotesi concorrenti, testare le controprove, applicare la falsificazione e verificare se le conclusioni rimangono stabili sotto inquadrature alternative. L'obiettivo non è rendere il modello "meno d'accordo", ma rendere le sue conclusioni meno dipendenti dall'inquadratura iniziale dell'utente.