
Suppression de sources de paquets APT doubles : Guide expert pour Ubuntu et Debian
Le fichier principal de configuration (/etc/apt/sources.list) :
Le répertoire de configuration (/etc/apt/sources.list.d/) :
Diminution des messages d'erreur :
apt update
Accélération du processus d'actualisation :
Mise en œuvre améliorée de la stabilité du système :
Amélioration de la lisibilité :
sources.list.d
Étape 1 : Diagnostic avec apt update
sudo apt update
main/binary-amd64/Packages
Étape 2 : Vérification manuelle des fichiers de configuration
/fr/etc/apt/sources.list.d/
/fr/etc/apt/sources.list
Étape 3 : Suppression des doublons
/fr/etc/apt/sources.list.d/
/fr/etc/apt/sources.list.d/
/fr/etc/apt/sources.list
Related Articles
Bases de données vectorielles, plongements et reclassement : trois parties distinctes de la recherche
Les embeddings représentent le sens, les bases de données vectorielles récupèrent des candidats, et les rerankers affinent les résultats. Découvrez comment ces trois couches de récupération diffèrent et fonctionnent ensemble dans le RAG.
Guide complet des métriques pour la livraison et la gestion du changement
Ce guide fournit un aperçu détaillé des métriques essentielles pour la livraison et la gestion du changement en entreprise, aidant les équipes à mesurer la performance, optimiser les processus et favoriser l'amélioration continue. Découvrez les indicateurs clés, les méthodes de calcul et les meilleures pratiques pour aligner vos métriques sur les résultats commerciaux.
Guide complet d'Evaluation Harness : Maîtriser l'évaluation des performances des LLM
Ce guide propose une présentation détaillée d'Evaluation Harness, un framework essentiel pour évaluer rigoureusement les capacités des grands modèles de langage (LLM) dans les pipelines LLMOps d'entreprise. Découvrez la configuration, les meilleures pratiques et les techniques avancées pour garantir un benchmarking et une optimisation fiables des modèles.
Le GPU n'est pas le produit : architecture d'IA privée pérenne
Une infrastructure d'IA privée ne devrait pas être conçue autour d'un seul GPU ou d'un seul modèle. Une approche plus résiliente combine des GPU d'inférence rapides, des systèmes d'IA riches en mémoire, des nœuds d'IA physique et des modèles cloud de pointe optionnels derrière une couche de routage prenant en compte les capacités.
Falsification pour le raisonnement de l'IA : des réponses aux hypothèses testées
Les modèles d’IA peuvent générer des preuves convaincantes pour presque toute hypothèse plausible. Une méthodologie plus fiable pose la question inverse : quelles preuves affaibliraient, contrediraient ou nous forceraient à abandonner la conclusion ? Cet article développe un raisonnement orienté vers la falsification pour les LLM en utilisant des hypothèses concurrentes, des tests discriminants, des contre-preuves et des critères de rejet explicites.
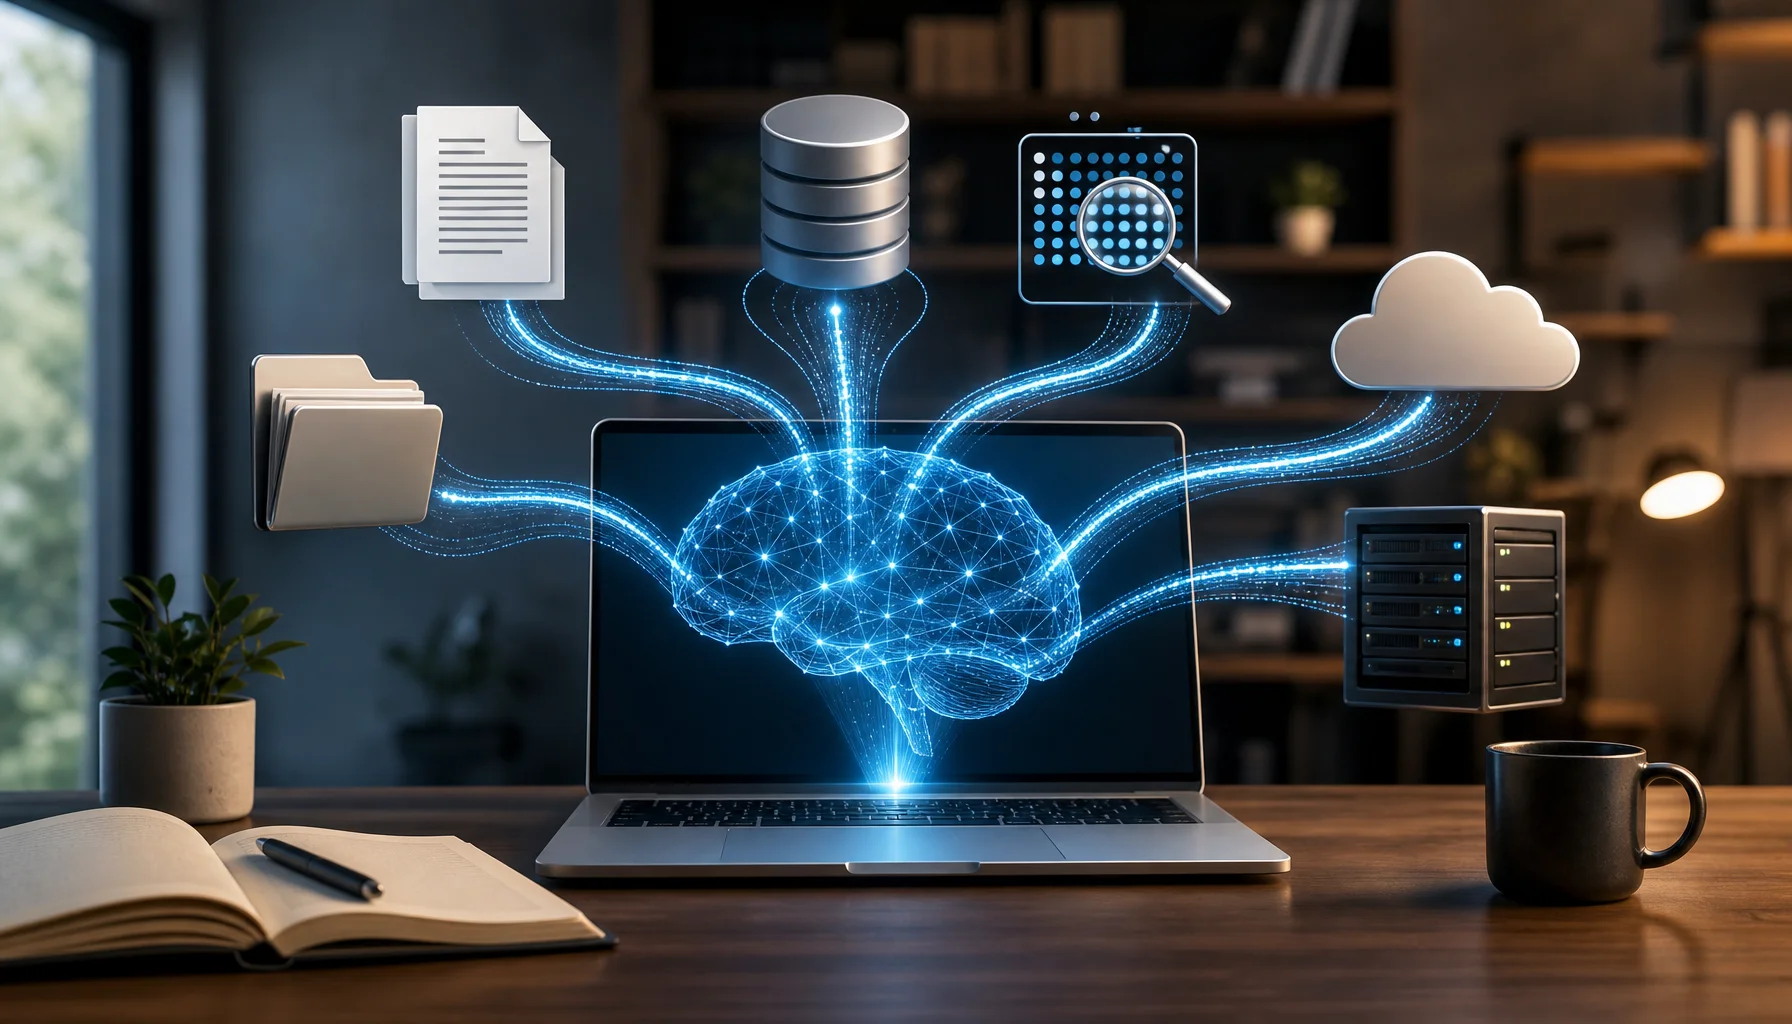
D'où un LLM tire-t-il ses données ? Sources de données RAG en Python
Un LLM ne connaît pas magiquement vos fichiers, bases de données ou API. Cette suite pratique de la série sur le RAG montre, avec du Python simple, comment des données externes deviennent des preuves récupérables : des fichiers texte et du SQL à la recherche en texte intégral, aux embeddings, à l'assemblage du contexte et à l'appel final au LLM.
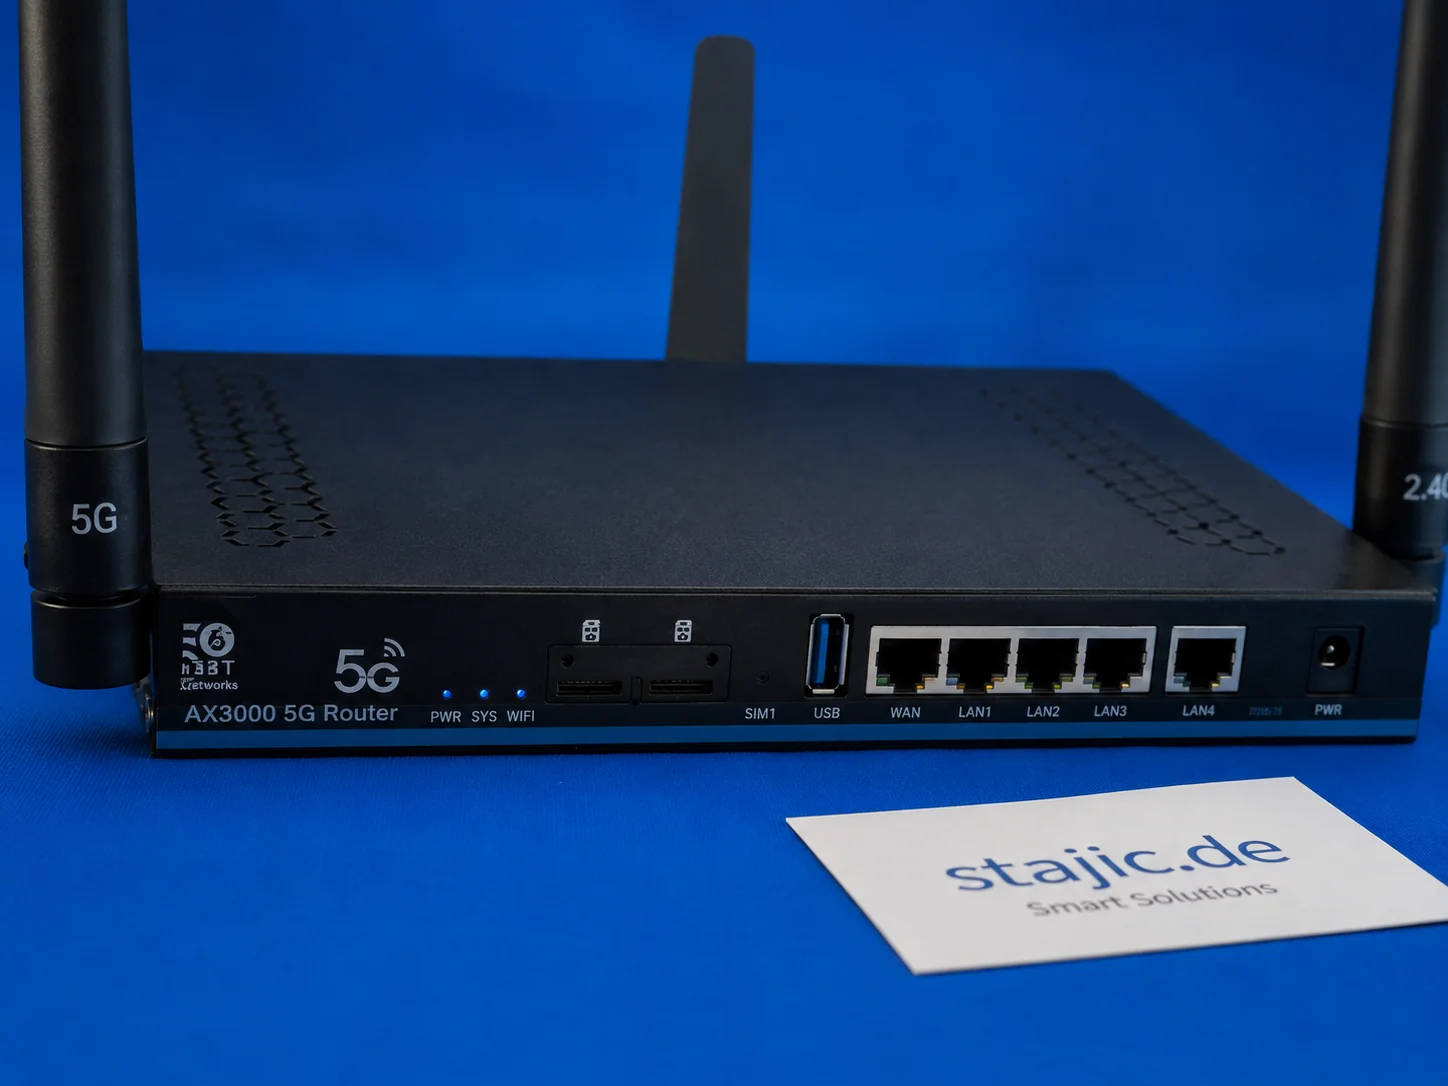
Quectel RM500U-EA dans le ZBT Z8102AX : bandes 5G, o2 Allemagne et comportement du signal en conditions réelles
Le ZBT Z8102AX utilise un modem Quectel RM500U-EA pour la connectivité 4G et 5G. Lors du premier test pratique, le routeur s'est connecté avec succès à o2 Germany avec la bande LTE 3 et la NR n28. Le modem fonctionne, mais des diagnostics plus approfondis tels que le RSRP, le RSRQ, le SINR, le verrouillage de bande et le comportement des cellules nécessitent encore des tests appropriés.
Une Architecture Monorepo Pratique avec Next.js, Fastify, Prisma, et NGINX
Explorez une architecture de monorepo pratique utilisant Next.js, Fastify, Prisma et NGINX, mettant en évidence l'intégration et le flux de travail concrets.
MCP expliqué : ce qu'il connecte, ce qu'il ne fait pas et où il s'intègre
Le protocole de contexte de modèle connecte les applications d’IA à des outils, des ressources et des invites externes par le biais d’une frontière standard client-serveur. Découvrez ce que fait le MCP, ce qu’il ne fait pas et où il s’intègre dans l’architecture des agents.
Guide complet de Test DEv Enterprise Stajic.de : architecture et bonnes pratiques
Explorez les principes architecturaux, les avantages et les détails techniques de la gestion d'un environnement de développement et de test de niveau entreprise avec Test DEv Enterprise Stajic.de.
Harnais d'agent géré vs boucle d'agent auto-hébergée : ce que vous gagnez, ce que vous perdez
“Agent auto-hébergé” peut désigner des architectures très différentes. Ce guide distingue le harnais géré, l'environnement d'exécution auto-hébergé et la boucle d'agent entièrement auto-opérée—et montre de quelle frontière de contrôle les équipes ont réellement besoin.
Pourquoi l'IA récupère-t-elle certaines sources et en ignore-t-elle d'autres ? — La couche d'autorité de récupération
Trouver un document pertinent ne suffit pas. Les systèmes d’IA doivent aussi distinguer les sources actuelles, faisant autorité, applicables et traçables des sources qui semblent simplement similaires. La couche d’autorité de récupération définit cette frontière de sélection des sources.