Marketing de bases de datos – Enfoque moderno para las relaciones con los clientes
Marketing de bases de datos: Un enfoque moderno para las relaciones con los clientes
En mi trayectoria profesional, he implementado numerosos proyectos en el ámbito del marketing de bases de datos y la gestión de relaciones con los clientes. El objetivo siempre ha sido apoyar a las empresas para fortalecer de manera sostenible sus relaciones con los clientes mediante el uso específico de datos y tecnología moderna.
Este artículo se basa en experiencias prácticas, así como en conocimientos estratégicos y técnicos de proyectos reales en el ámbito del marketing y la TI.
¿Por qué es importante el marketing de bases de datos?
En la economía digital, la gestión eficaz de los datos de los clientes decide el éxito de una empresa. El marketing de bases de datos permite recopilar, evaluar y utilizar información relevante de forma específica para medidas de marketing personalizadas.
Las empresas pueden así optimizar la adquisición de clientes, fidelizar a los clientes a largo plazo, crear ofertas personalizadas y utilizar los presupuestos de marketing de manera más eficiente.
Los fundamentos del marketing de bases de datos
El marketing de bases de datos exitoso se basa en tres pilares centrales que deben implementarse de manera técnica y organizativa impecable.
- Recopilación de datos: Captura de datos relevantes de clientes de sitios web, sistemas CRM, redes sociales y transacciones.
- Análisis de datos: Uso de herramientas de análisis modernas para identificar patrones, preferencias y comportamiento del cliente.
- Automatización: Sistemas para el procesamiento de datos en tiempo real y para el lanzamiento de campañas automatizadas.
Desafíos en el marketing de bases de datos
A pesar de su gran potencial, las empresas se enfrentan a varios desafíos en el marketing de bases de datos, tanto de naturaleza técnica como organizativa.
- Calidad de los datos: Datos incompletos o erróneos conducen a decisiones incorrectas.
- Integración: Diferentes fuentes de datos deben ser transferidas a un sistema consistente.
- Protección de datos: El cumplimiento del RGPD y el almacenamiento seguro de datos sensibles de clientes son obligatorios.
Implementación técnica en el marketing de bases de datos
Desde un punto de vista técnico, el marketing de bases de datos requiere una arquitectura limpia y flujos de datos claramente definidos. La escalabilidad, la seguridad y la mantenibilidad son el foco principal.
- APIs para la integración de sistemas CRM, ERP y de terceros.
- Data Warehousing para el almacenamiento centralizado y el análisis de grandes volúmenes de datos.
- Uso de IA y Machine Learning para el reconocimiento de patrones y predicciones.
- Plataformas en la nube para escalabilidad e infraestructura flexible.
- Medidas de seguridad como cifrado y controles de acceso.
Mejores prácticas para un marketing de bases de datos exitoso
De la práctica se han establecido claras mejores prácticas que ayudan a las empresas a explotar todo el potencial de sus datos.
- Limpieza y validación regular de la base de datos.
- Segmentación de clientes significativa para campañas personalizadas.
- Uso de herramientas de automatización de marketing para procesos eficientes.
- Medición de KPIs relevantes como tasas de conversión y fidelización de clientes.
Conclusión
El marketing de bases de datos es una herramienta indispensable para las empresas que desean fortalecer sus relaciones con los clientes y crecer de forma sostenible. La combinación de tecnología moderna, pensamiento estratégico y análisis fundamentado permite medidas de marketing eficientes, personalizadas y medibles.
Con experiencia técnica y conocimientos estratégicos, apoyo a las empresas para utilizar estos potenciales de manera específica y sostenible.
Related Articles
La memoria del agente de IA no es RAG: cómo separar memoria, recuperación, estado y contexto
La memoria del agente, RAG, el estado y el contexto a menudo se usan como si fueran intercambiables. No lo son. Este modelo práctico de arquitectura separa las cuatro capas, muestra dónde pertenece cada una y explica qué se rompe cuando los sistemas las colapsan en una sola.
¿Puede la evidencia sobrevivir al flujo de trabajo de la IA? — La cadena de preservación de evidencia
Las pruebas pueden ser correctas en la fuente y aun así volverse poco fiables después del análisis, la normalización, la fragmentación, la recuperación y el ensamblaje del contexto. La Cadena de Preservación de Pruebas rastrea si la identidad, la procedencia, el alcance y el significado sobreviven a todo el proceso de IA.
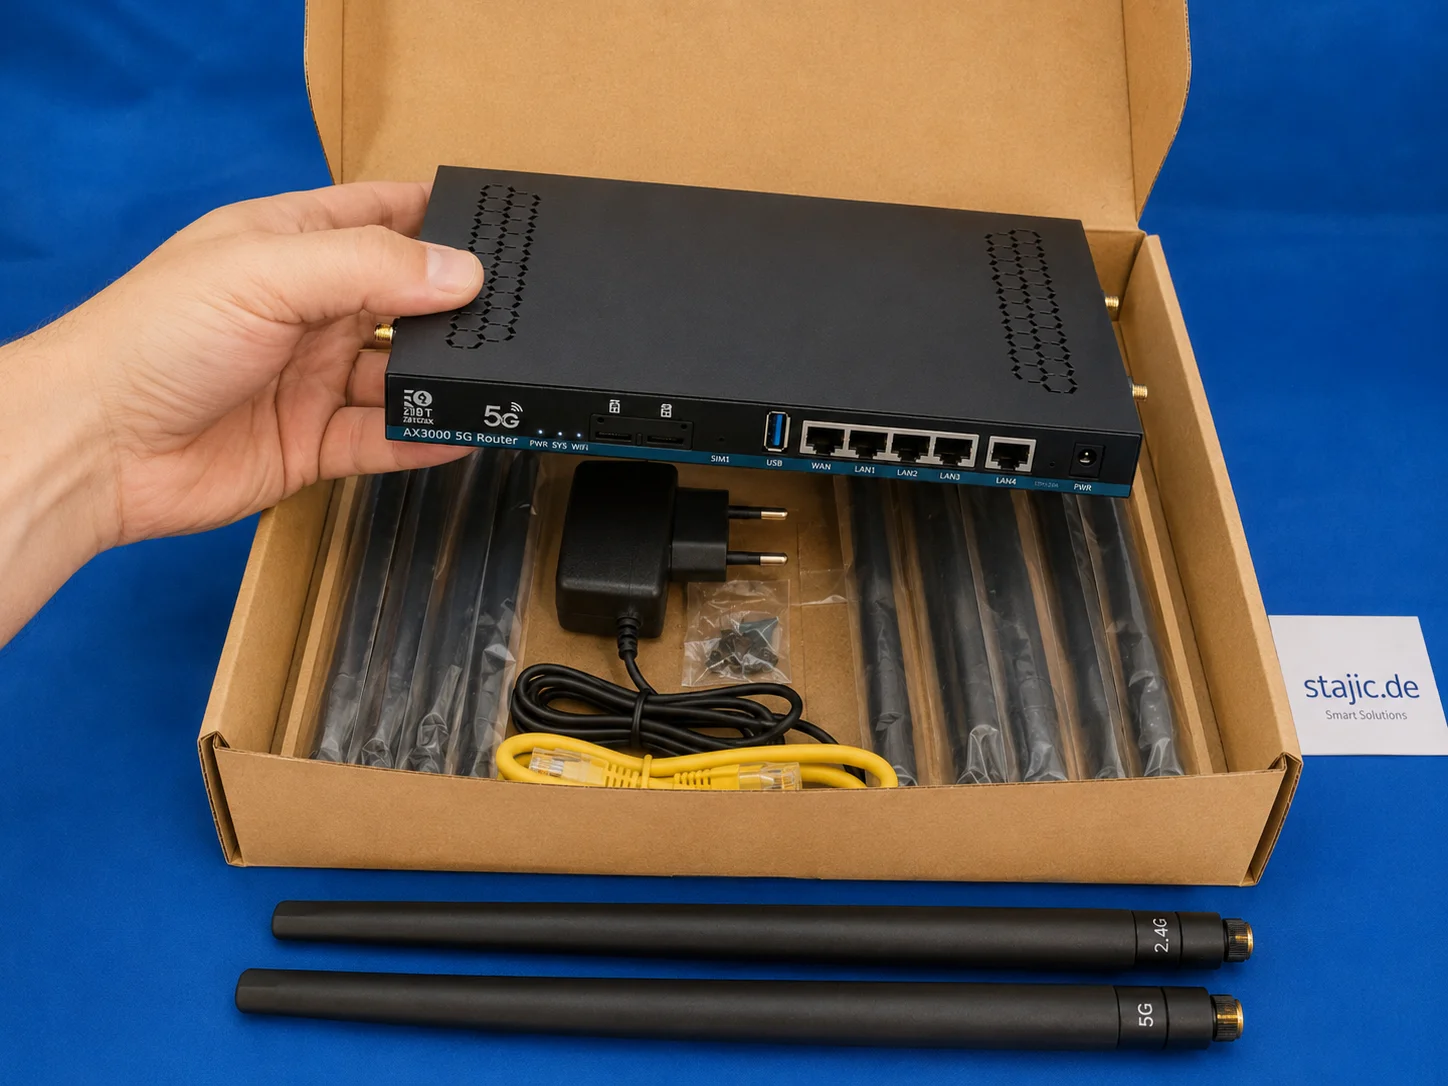
Reseña de hardware y embalaje del ZBT Z8102AX: Router fuerte, caja débil
El ZBT Z8102AX causa una primera impresión sólida como un delgado router OpenWrt 5G de metal negro con múltiples conectores de antena, ranuras para doble SIM, puertos USB, LAN/WAN y un práctico juego de accesorios. El hardware se siente útil y serio, pero el embalaje es claramente el punto débil.
Cómo saber si un agente de IA realmente utilizó la evidencia correcta
Un agente de IA puede citar fuentes y aun así usar la evidencia incorrecta. Este artículo presenta un método práctico para verificar el respaldo de las afirmaciones, la autoridad de la fuente, la aplicabilidad, la procedencia y si la evidencia realmente influyó en la respuesta.
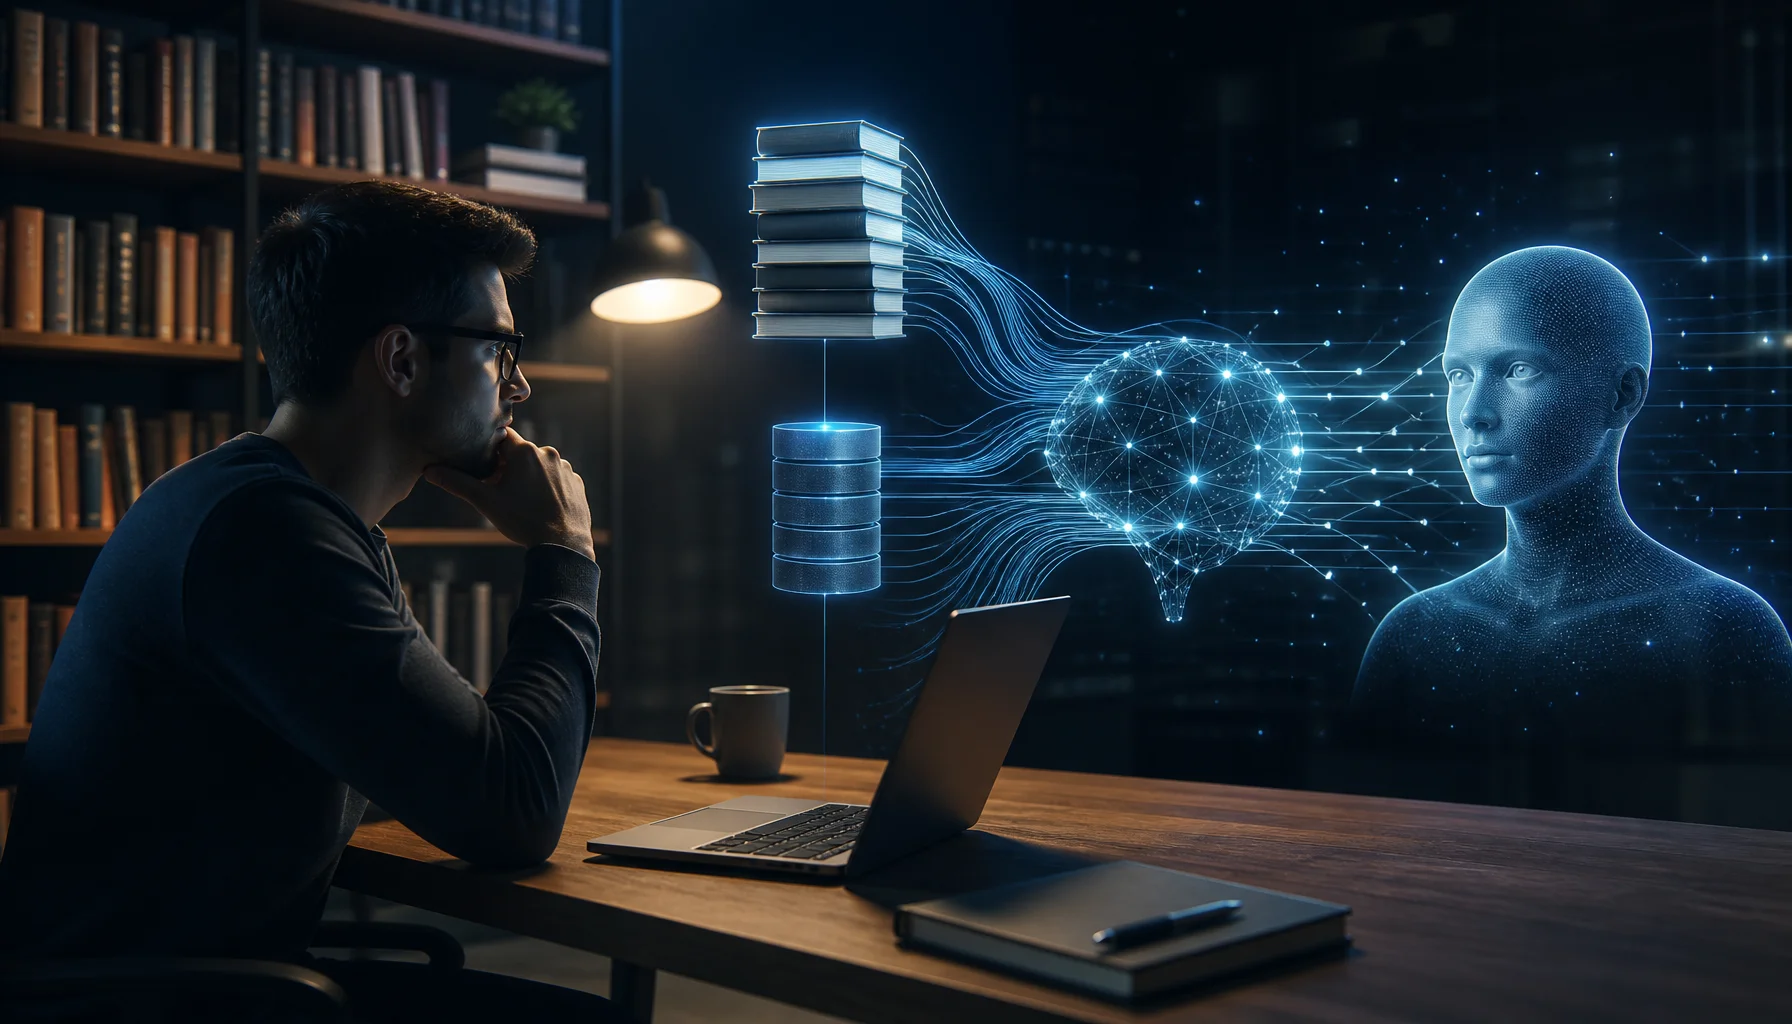
¿Qué es RAG? La explicación más sencilla de cómo funciona
RAG suena complicado, pero la idea es simple: antes de que una IA responda, primero busca información útil de una fuente de conocimiento y le da esa información al modelo de lenguaje. Esta guía explica RAG, los LLM, el estado, la memoria y las herramientas usando un modelo mental simple.
Gobernanza de la IA: modelos, datos, permisos, riesgo y auditabilidad
La gobernanza de la IA define quién puede aprobar, operar, cambiar y auditar los sistemas de IA en todos los modelos, proveedores, datos, permisos, riesgos, evaluación y el ciclo de vida completo.
Qwen 3.6 en producción: Runbook de lanzamiento, rollback de IA y versionado de LLMOps
Qwen 3.6 no es solo otra actualización de modelo. Es un evento de lanzamiento, un escenario de reversión y un problema de versionado al mismo tiempo. Este artículo explica cómo debe manejarse Qwen 3.6 en producción a través de la disciplina de LLMOps, la trazabilidad de prompts y modelos, el despliegue controlado y la preparación para la reversión basada en evidencia.
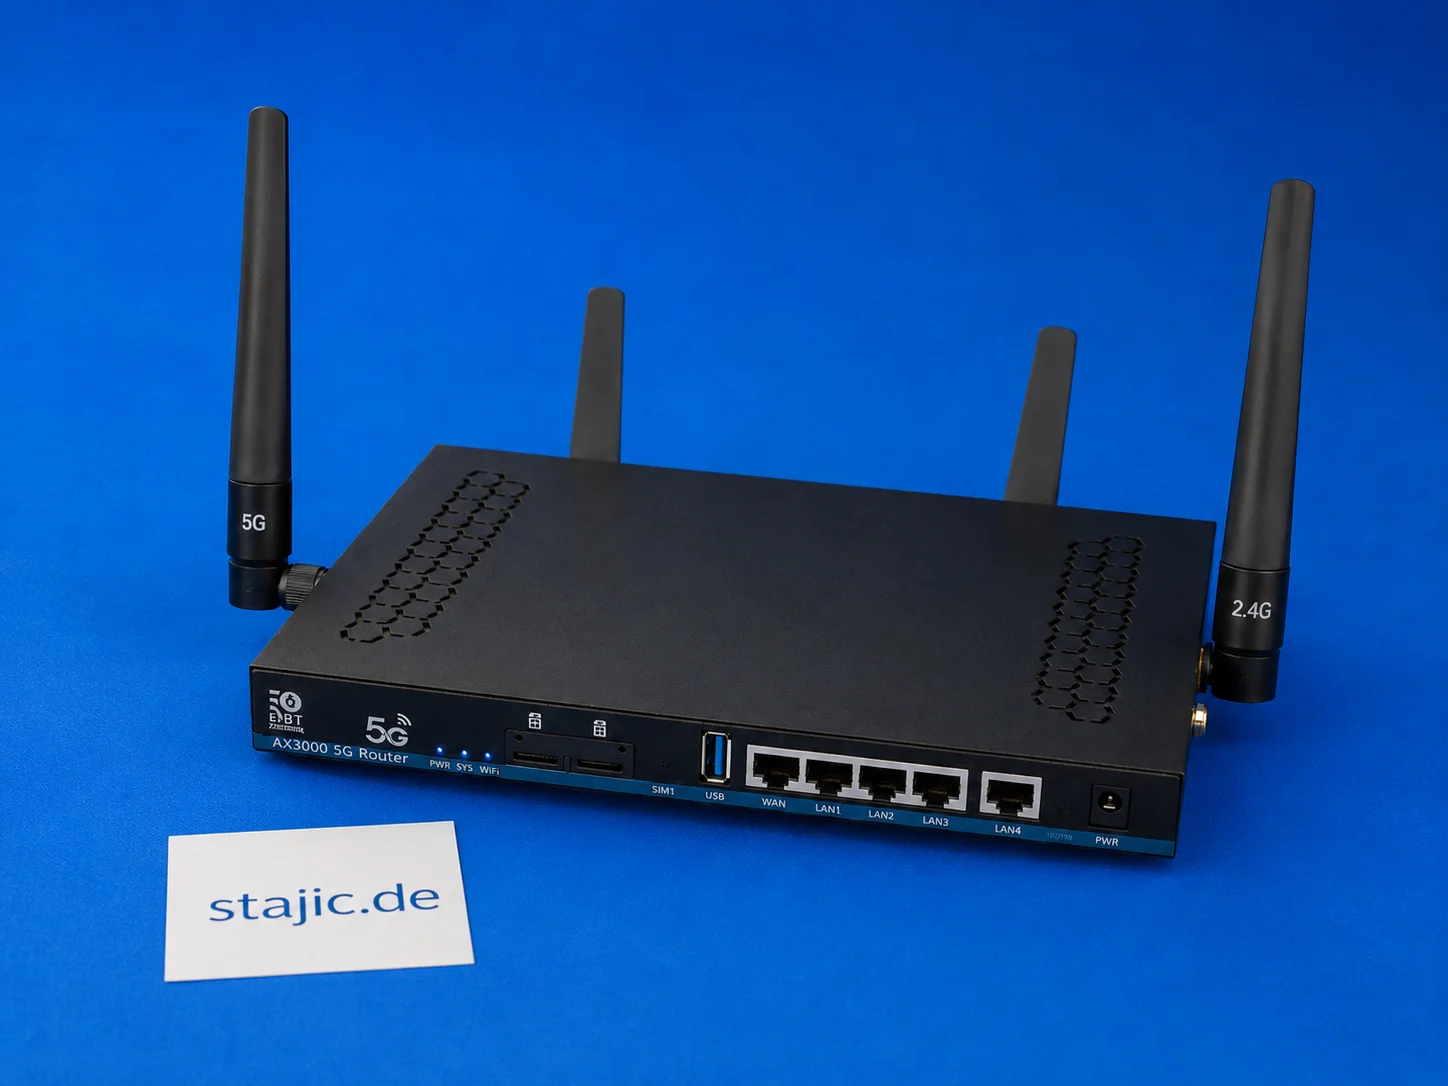
Conmutación por error de doble SIM del ZBT Z8102AX: qué funciona, qué falta y qué necesita un mejor firmware
El ZBT Z8102AX es un router OpenWrt 5G de doble SIM, pero el hardware de doble SIM por sí solo no es lo mismo que una conmutación por error inteligente. El router reconoce la SIM y se conecta correctamente, pero el cambio automático, la recuperación del módem, las decisiones basadas en la señal y una lógica de conmutación por error limpia aún necesitan pruebas más profundas.
Falsación para el razonamiento de IA: De respuestas a hipótesis comprobadas
Los modelos de IA pueden generar evidencia convincente para casi cualquier hipótesis plausible. Una metodología más fiable plantea la pregunta opuesta: ¿qué evidencia debilitaría, contradiría o nos obligaría a abandonar la conclusión? Este artículo desarrolla un razonamiento orientado a la falsación para los LLM utilizando hipótesis rivales, pruebas discriminantes, contraevidencia y criterios de rechazo explícitos.
Ollama no es el producto: Construcción de aplicaciones de LLM abiertos listas para producción
Ejecutar un modelo local con Ollama es fácil. Construir una aplicación Open-LLM lista para producción es más difícil: requiere RAG, control de acceso, abstracción de proveedores, evaluación, registro, disciplina de despliegue y una capa de aplicación controlada alrededor del modelo.
Google I/O 2026: Giros arquitectónicos, IA agéntica y la dosis de realidad del ecosistema unificado
Google I/O 2026 no fue solo un evento de modelos. Mostró un cambio de plataforma más profundo en los modelos Gemini, las herramientas de desarrollo, las superficies vinculadas a Android y los dispositivos inteligentes. Este artículo desglosa la conferencia principal como un artículo central para ingenieros, arquitectos y equipos de producto que necesitan separar las implicaciones reales en tiempo de ejecución de la exageración del escenario.
IA soberana: control de modelos, datos, infraestructura y dependencias
La IA soberana se trata del control efectivo sobre los modelos, los datos, la infraestructura, el software, las operaciones y las dependencias estratégicas, no simplemente de dónde está alojado un modelo de IA.