
Cómo saber si un agente de IA realmente utilizó la evidencia correcta

Un agente de IA puede citar fuentes, recuperar documentos y, aun así, utilizar la evidencia equivocada. Una fuente puede ser fidedigna pero irrelevante para la afirmación exacta. Un fragmento recuperado puede respaldar solo una parte de la respuesta. Una fuente correcta puede estar obsoleta, desactualizada o ser válida para una jurisdicción, versión de producto, usuario o estado del sistema incorrectos. Esto genera un problema de evaluación más complejo que la simple verificación de citas: ¿utilizó realmente el agente la evidencia adecuada para la afirmación realizada?
Por qué las citas no son suficientes
Una cita responde únicamente a una pregunta acotada: si el sistema asoció una afirmación o respuesta con una fuente. No determina automáticamente que la fuente respalde la afirmación específica, que sea lo suficientemente fidedigna para la tarea, que el pasaje citado contenga la condición o excepción necesaria, o que el modelo se haya basado en esa evidencia en lugar de generar la respuesta a partir de su conocimiento previo.
La guía de Anthropic para la evaluación de agentes de investigación separa explícitamente la fundamentación, la cobertura y la calidad de las fuentes. De manera similar, la guía de evaluación de agentes de OpenAI enfatiza las trazas porque el resultado final no revela si el agente seleccionó las herramientas adecuadas o siguió el flujo de trabajo previsto. Estas ideas apuntan a una conclusión más amplia: la calidad de la evidencia es una propiedad de la ruta de ejecución, no solo del texto final.
Las cuatro preguntas que toda afirmación relevante debe superar
| Dimensión | Pregunta | Fallo típico |
|---|---|---|
| Respaldo de la afirmación | ¿La evidencia respalda directamente esta afirmación exacta? | La fuente está relacionada temáticamente, pero no fundamenta la afirmación |
| Autoridad de la evidencia | ¿Es esta una fuente apropiada para este tipo de afirmación? | Se utiliza un resumen secundario donde se requiere una fuente primaria o un sistema en vivo |
| Aplicabilidad | ¿Se aplica la evidencia a este momento, versión, jurisdicción, usuario, estado o población? | Se aplica una afirmación verdadera fuera de sus condiciones válidas |
| Uso de la evidencia | ¿Estuvo esta evidencia realmente disponible y se utilizó en la ruta de ejecución del agente? | La respuesta final es correcta, pero la evidencia recuperada era irrelevante o no se utilizó |
1. Respaldo de la afirmación: ¿fundamenta la fuente lo que afirma el agente?
La evidencia debe evaluarse a nivel de afirmación. Un documento puede ser relevante para el tema y, aun así, no respaldar una declaración específica. Si una fuente señala que una función está disponible en regiones seleccionadas, la respuesta «la función está disponible a nivel global» carece de respaldo, aunque la cita parezca verosímil.
Aquí es donde las valoraciones generales de «fundamentado / no fundamentado» suelen ser demasiado imprecisas. Divida la respuesta en afirmaciones relevantes, asocie cada afirmación con el fragmento de evidencia más pequeño que la respalde y clasifique la relación: respaldo directo, respaldo parcial, contradicción o sin respaldo.
2. Autoridad de la evidencia: ¿es el tipo de fuente adecuado?
La selección correcta de la evidencia no consiste únicamente en la relevancia semántica. La fuente debe ser adecuada para la decisión. El estado actual de una cuenta debe provenir del sistema de cuentas, no de un correo electrónico antiguo. Una afirmación sobre el comportamiento de una API debería contrastarse preferiblemente con la documentación actual del proveedor o con un comportamiento reproducible. Un requisito legal puede requerir la ley aplicable, el organismo regulador o directrices oficiales en lugar de una publicación genérica de un blog.
La autoridad de la fuente depende de la tarea específica. Un informe de la comunidad puede ser la mejor evidencia para un error real que la documentación del proveedor no reconoce. Un comunicado del proveedor puede ser fidedigno respecto a lo que este afirma, pero constituir una evidencia débil sobre el rendimiento independiente. Por lo tanto, el evaluador necesita una jerarquía de fuentes explícita para la tarea en lugar de una puntuación de autoridad universal.
3. Aplicabilidad: evidencia correcta, condiciones incorrectas
Los errores de evidencia más peligrosos a menudo no provienen de fuentes inventadas, sino de fuentes válidas utilizadas fuera de sus límites. Una recomendación puede cambiar según la versión del software, la fecha, la jurisdicción, la revisión del hardware, los permisos del usuario, la disponibilidad del producto, el estado actual del juego, la configuración del inquilino (tenant) u otras variables del entorno.
Para cada fuente relevante, conserve las condiciones que determinan si aún resulta aplicable. Esto es especialmente importante tras una síntesis: una memoria comprimida o una cita puede preservar la conclusión al tiempo que omite la excepción, la fecha o el requisito previo que validaba dicha conclusión.
4. Uso de la evidencia: ¿realmente se basó el agente en la evidencia?
Una respuesta puede ser correcta incluso cuando la recuperación falló. El modelo ya puede conocer la respuesta, inferirla de un contexto no relacionado o simplemente acertar por casualidad. Si la evaluación comprueba únicamente la corrección final, el sistema puede parecer bien fundamentado mientras que la ruta de la evidencia está rota.
Para evaluar el uso de la evidencia, inspeccione la traza. Confirme qué fuentes se recuperaron, qué pasajes llegaron al contexto del modelo, cuándo estuvieron disponibles y si la afirmación final puede explicarse mediante esas entradas. Las herramientas actuales de evaluación de agentes de OpenAI enfatizan la calificación de trazas precisamente porque el comportamiento a nivel de flujo de trabajo no se puede reconstruir de manera confiable solo a partir de la respuesta final.
La prueba de utilización de la evidencia
Se puede construir una evaluación práctica como un contrafáctico controlado. En lugar de preguntar únicamente si la respuesta es correcta, cambie la evidencia y observe si la afirmación cambia en la dirección esperada.
Prueba de utilización de la evidencia
Una matriz de afirmación-evidencia es más útil que una lista de fuentes
| Afirmación | Evidencia | Respaldo | Autoridad | Aplicabilidad | Utilizado en la traza |
|---|---|---|---|---|---|
| La función X está disponible | Documentación del proveedor | Directo | Alta para afirmaciones de disponibilidad | La versión actual y la región deben coincidir | Sí / No |
| La configuración Y es más rápida | Benchmark del proveedor | Parcial | Alta para la prueba del proveedor, no para rendimiento independiente | El hardware y la carga de trabajo deben coincidir | Sí / No |
| La política se aplica a este usuario | Política actual + estado de la cuenta | Directo solo cuando se combinan | Alta | La jurisdicción, fecha, rol y estado de la cuenta deben coincidir | Sí / No |
| Un producto está en stock | API de inventario en tiempo real | Directo | Autorizada para el stock actual | Caduca rápidamente | Sí / No |
Esta matriz plantea varias preguntas que la verificación convencional de citas oculta. Una afirmación puede requerir múltiples fuentes. Una fuente puede respaldar solo una parte de una afirmación. Una fuente autorizada puede tener una ventana de validez corta. Y una fuente perfectamente válida puede ser irrelevante si nunca ingresó a la ruta de ejecución.
Separar la calidad de la recuperación de la calidad de la evidencia
Las métricas de recuperación evalúan si se encontró y clasificó el material relevante. La evaluación de la evidencia analiza si ese material justifica las afirmaciones resultantes. Ambas están relacionadas pero no son idénticas.
El éxito en la recuperación no es el éxito en la evidencia
| Situación | Recuperación | Calidad de la evidencia | |
|---|---|---|---|
| Documento correcto, afirmación incorrecta | |||
| Dato correcto, fuente desactualizada | |||
| Fuente débil, respuesta correcta | |||
| Múltiples fuentes requeridas |
Evaluar la calidad de la fuente como una rúbrica, no como una lista blanca de dominios
Las listas fijas de "dominios de confianza" son tentadoras pero a menudo frágiles. En cambio, la calidad de la fuente debe reflejar el tipo de afirmación. Las dimensiones útiles incluyen el estatus primario o secundario, la actualidad, la inmediatez, la reproducibilidad, la independencia, la experiencia en el dominio, la procedencia de los datos, la cadencia de actualización y si la fuente tiene incentivos para exagerar la afirmación.
La guía de evaluación de agentes de investigación de Anthropic señala explícitamente las comprobaciones de calidad de la fuente junto con la fundamentación y la cobertura. Por lo tanto, la implementación práctica debe calificar tanto lo que dice la fuente como si dicha fuente es apropiada para este tipo de declaración.
Cobertura de la evidencia: cada afirmación importante necesita respaldo, no cada oración
No todas las oraciones necesitan una cita. El lenguaje de transición, la aritmética derivada de forma transparente a partir de valores citados o una interpretación claramente señalada pueden no requerir una fuente independiente. Sin embargo, cada afirmación relevante y verificable externamente debe contar con el respaldo suficiente para que un evaluador pueda reconstruir por qué se le permitió al agente expresarla.
Por lo tanto, la cobertura debe ponderarse según la importancia de la afirmación. La falta de respaldo para un detalle decorativo no equivale a la falta de respaldo para un precio, una decisión de elegibilidad, una instrucción de seguridad, un requisito legal, una declaración de compatibilidad técnica o un hecho que fundamente una recomendación.
La procedencia de la evidencia debe sobrevivir a la síntesis y a la memoria
Los agentes de ejecución prolongada a menudo resumen el trabajo previo o registran memorias duraderas. Si la procedencia de la evidencia se elimina durante esa transformación, los agentes futuros pueden recuperar una conclusión clara sin saber si provino de una declaración del usuario, una API en tiempo real, un documento antiguo, una inferencia del modelo o un resultado web no verificado.
Para hechos importantes, conserve al menos la identidad de la fuente, la hora de recuperación u observación, el tipo de evidencia, la versión o estado relevante, y si el texto almacenado está citado, resumido, inferido o derivado. La procedencia es lo que permite que un agente posterior decida si se debe confiar en la evidencia, actualizarla, restringirla o descartarla.
Un registro práctico de evidencia
| Campo | Propósito |
|---|---|
| claim_id | Identifica la afirmación relevante que se está respaldando |
| source_id / source_url / system | Identifica de dónde provino la evidencia |
| evidence_span | Conserva el fragmento, registro o resultado de herramienta más pequeño que respalda la afirmación |
| retrieved_at / observed_at | Permite verificar la actualidad y la cronología |
| source_version / object_version | Permite comprobar la sustitución y la reproducibilidad |
| authority_role | Explica por qué esta fuente es adecuada para esta afirmación |
| applicability | Almacena la fecha relevante, jurisdicción, versión del producto, usuario, inquilino, estado u otras condiciones |
| transformation | Indica si la evidencia es sin procesar, citada, resumida, normalizada o derivada |
| trace_step | Muestra cuándo estuvo disponible la evidencia para el agente |
| support_status | Directo, parcial, contradictorio, no respaldado o incierto |
Modos de fallo que parecen fundamentados pero no lo están
| Modo de fallo | Por qué engaña a los evaluadores | Qué evaluar |
|---|---|---|
| Decoración de citas | La respuesta contiene fuentes, por lo que parece investigada | Mapear cada afirmación relevante a un fragmento de respaldo exacto |
| Discrepancia de autoridad | La fuente es confiable pero no tiene autoridad para el hecho específico | Definir una jerarquía de fuentes específica para la afirmación |
| Discrepancia temporal | La fuente era correcta en el momento de su publicación | Verificar la fecha de recuperación, la fecha de la fuente y la evidencia que la sustituye |
| Eliminación de condiciones | Un resumen conserva la conclusión pero omite las excepciones | Comparar la afirmación generada con el contexto local completo de la fuente |
| Cita a posteriori | Se adjunta una fuente plausible después de generar la respuesta | Inspeccionar el orden de la traza y verificar si la evidencia precedió a la afirmación |
| Anulación paramétrica | El modelo ignora la evidencia recuperada y responde a partir de su conocimiento previo | Ejecutar pruebas contrafácticas de utilización de evidencia |
| Blanqueo de evidencia | La inferencia del modelo se resume y luego se almacena como si fuera un hecho de la fuente | Preservar el tipo de transformación y la procedencia a través de las escrituras en la memoria |
| Falacia de la mayoría de fuentes | Varias páginas secundarias repiten la misma afirmación sin respaldo | Rastrear las afirmaciones hasta la evidencia primaria o independiente |
Cómo evaluar al agente en producción
Canalización de evaluación de evidencia
La guía de evaluación actual de OpenAI recomienda evaluaciones específicas para cada tarea, evaluación continua, conjuntos de datos derivados de producción y trazas para depurar el comportamiento de los agentes. Del mismo modo, Anthropic aconseja combinar tipos de evaluadores para agentes de investigación, dado que la corrección, la calidad de las fuentes, la cobertura y la fundamentación son dimensiones independientes. La evaluación de la evidencia debe seguir el mismo patrón: varios evaluadores específicos resultan más diagnósticos que una única puntuación de "calidad" opaca.
No permita que un juez LLM sea el único evaluador de evidencia
Los evaluadores basados en LLM son útiles para la clasificación escalable de afirmaciones, verificaciones de relevancia y comparaciones por pares, pero pueden compartir los mismos puntos ciegos que el sistema que evalúan. Un evaluador puede aceptar una afirmación plausible pero no respaldada, pasar por alto un límite sutil entre versiones o sobrevalorar una fuente bien redactada.
La guía de evaluación de OpenAI recomienda calibrar los evaluadores automatizados con el juicio humano y utilizar criterios claros y delimitados. En sistemas que hacen un uso intensivo de evidencia, deben aplicarse comprobaciones deterministas siempre que sea posible: marcas de tiempo, versiones de objetos, alcance de permisos, identificadores de fuente exactos, orden de recuperación, hashes de documentos y si la evidencia estaba presente antes de que el modelo generara la afirmación.
¿Qué cambiaría esta respuesta?
La evaluación puede ser más sencilla cuando el agente opera sobre un corpus pequeño, inmutable y fidedigno, y cada respuesta es estrictamente extractiva. En ese entorno, la autoridad y la aplicabilidad de las fuentes son en su mayoría fijas, y el respaldo de la afirmación mediante fragmentos de texto puede ser suficiente.
La evaluación debe volverse más rigurosa cuando el agente combina búsquedas web, memoria a largo plazo, herramientas en tiempo real, múltiples jurisdicciones, información que cambia con rapidez, estados específicos del usuario o acciones autónomas. En esos sistemas, la validez de la evidencia no solo depende del texto de origen, sino también de cuándo y cómo se obtuvo dicha evidencia.
Los modelos futuros pueden volverse mejores rastreando internamente la procedencia y la incertidumbre, pero eso no eliminaría la necesidad de registros de evidencia externos en sistemas que requieren auditabilidad. Un sistema no debería depender del autoinforme del modelo sobre qué influyó en él cuando las trazas y los metadatos de las fuentes pueden proporcionar evidencia más sólida.
Limitaciones
No siempre es posible demostrar el uso causal de la evidencia solo a partir de las trazas. Una fuente puede estar presente en el contexto sin influir en la respuesta, y un modelo puede conocer de forma independiente el mismo hecho. Las pruebas contrafácticas refuerzan la inferencia, pero pueden alterar por sí mismas la distribución de la tarea.
La autoridad de las fuentes también puede ser discutible o depender del dominio. Algunas preguntas no tienen una única fuente autorizada y los expertos pueden estar en desacuerdo sobre qué evidencia merece mayor peso. En esos casos, el evaluador debe preservar el desacuerdo y puntuar la transparencia, la cobertura y el razonamiento frente a una rúbrica explícita en lugar de pretender que existe una única fuente de verdad incuestionable.
Conclusión
La pregunta “¿citó una fuente el agente?” es demasiado débil para la IA en producción. La pregunta más sólida es: ¿provino cada afirmación importante de evidencia que realmente la respalda, tiene la autoridad adecuada, sigue siendo aplicable a las condiciones actuales y estuvo disponible en la ruta de ejecución antes de que se formulara la afirmación?
Eso convierte la evidencia de un mero adorno en una propiedad evaluable del sistema. Capture la traza. Asocie las afirmaciones con la evidencia. Compruebe la autoridad y la aplicabilidad. Ejecute pruebas de evidencia contrafácticas. Preserve la procedencia a través de resúmenes y memoria. Así, una respuesta correcta no solo es plausible: cuenta con una ruta de evidencia que se puede inspeccionar.
Preguntas frecuentes
Evaluación del uso de evidencia en agentes de IA
¿Una cita demuestra que una respuesta de IA está fundamentada?
¿Cómo puedo comprobar si un agente de IA realmente utilizó la evidencia recuperada?
¿Cuál es la diferencia entre fundamentación y calidad de la fuente?
¿Por qué una fuente real aún puede producir una respuesta incorrecta de la IA?
¿Qué debería registrar para la evaluación de la evidencia?
Glosario
Términos clave en la evaluación de evidencia
- Respaldo de la afirmación
- El grado en que un fragmento de evidencia específico fundamenta directamente una afirmación generada.
- Aplicabilidad
- Las condiciones bajo las cuales la evidencia sigue siendo válida para una afirmación, incluidos el tiempo, la versión, la jurisdicción, el usuario, la población, el estado del sistema u otros límites.
- Utilización de evidencia
- Si el resultado generado por el agente responde realmente y depende de la evidencia facilitada en su ruta de ejecución.
- Prueba contrafáctica de evidencia
- Una evaluación que elimina, sustituye o modifica evidencia decisiva para comprobar si la afirmación del agente cambia de forma coherente.
- Procedencia
- Metadatos que registran de dónde provino la evidencia, cuándo se obtuvo, cómo se transformó y qué versión o estado representaba.
Fuentes primarias y lecturas adicionales
OpenAI — Evaluate Agent WorkflowsOrientación sobre la calificación de trazas, evaluación a nivel de flujo de trabajo, conjuntos de datos y ejecuciones de evaluación reproducibles para agentes.
OpenAI — Evaluation Best PracticesOrientación sobre evaluaciones específicas para tareas, conjuntos de datos derivados de producción, métricas acotadas, evaluación continua y calibración de calificadores.
Anthropic — Demystifying Evals for AI AgentsGuía de evaluación de agentes que incluye comprobaciones de fundamentación, cobertura y calidad de fuentes para agentes de investigación.
OpenAI — A Shared Playbook for Trustworthy Third-Party EvaluationsGuía de evaluación que subraya que el rendimiento de los agentes modernos depende del flujo de trabajo y del entorno, no solo del resultado final del modelo.
Related Articles

MCP vs A2A vs UCP vs AP2 vs A2UI: La pila de protocolos de agentes explicada
MCP, A2A, UCP, AP2 y A2UI a menudo se presentan como estándares de agentes competidores. En su mayoría, resuelven diferentes problemas de interoperabilidad. Esta guía mapea cada protocolo con el límite que realmente estandariza—y muestra cómo pueden funcionar juntos en un sistema de producción.

¿Qué debería recordar, olvidar, recalcular o volver a recuperar un agente de IA?
Los agentes de larga duración no deberían recordarlo todo. Este artículo proporciona un modelo práctico de ciclo de vida para decidir qué pertenece a la memoria duradera, qué se debería recuperar de nuevo, qué es más seguro recalcular y qué debería expirar o ser sustituido.
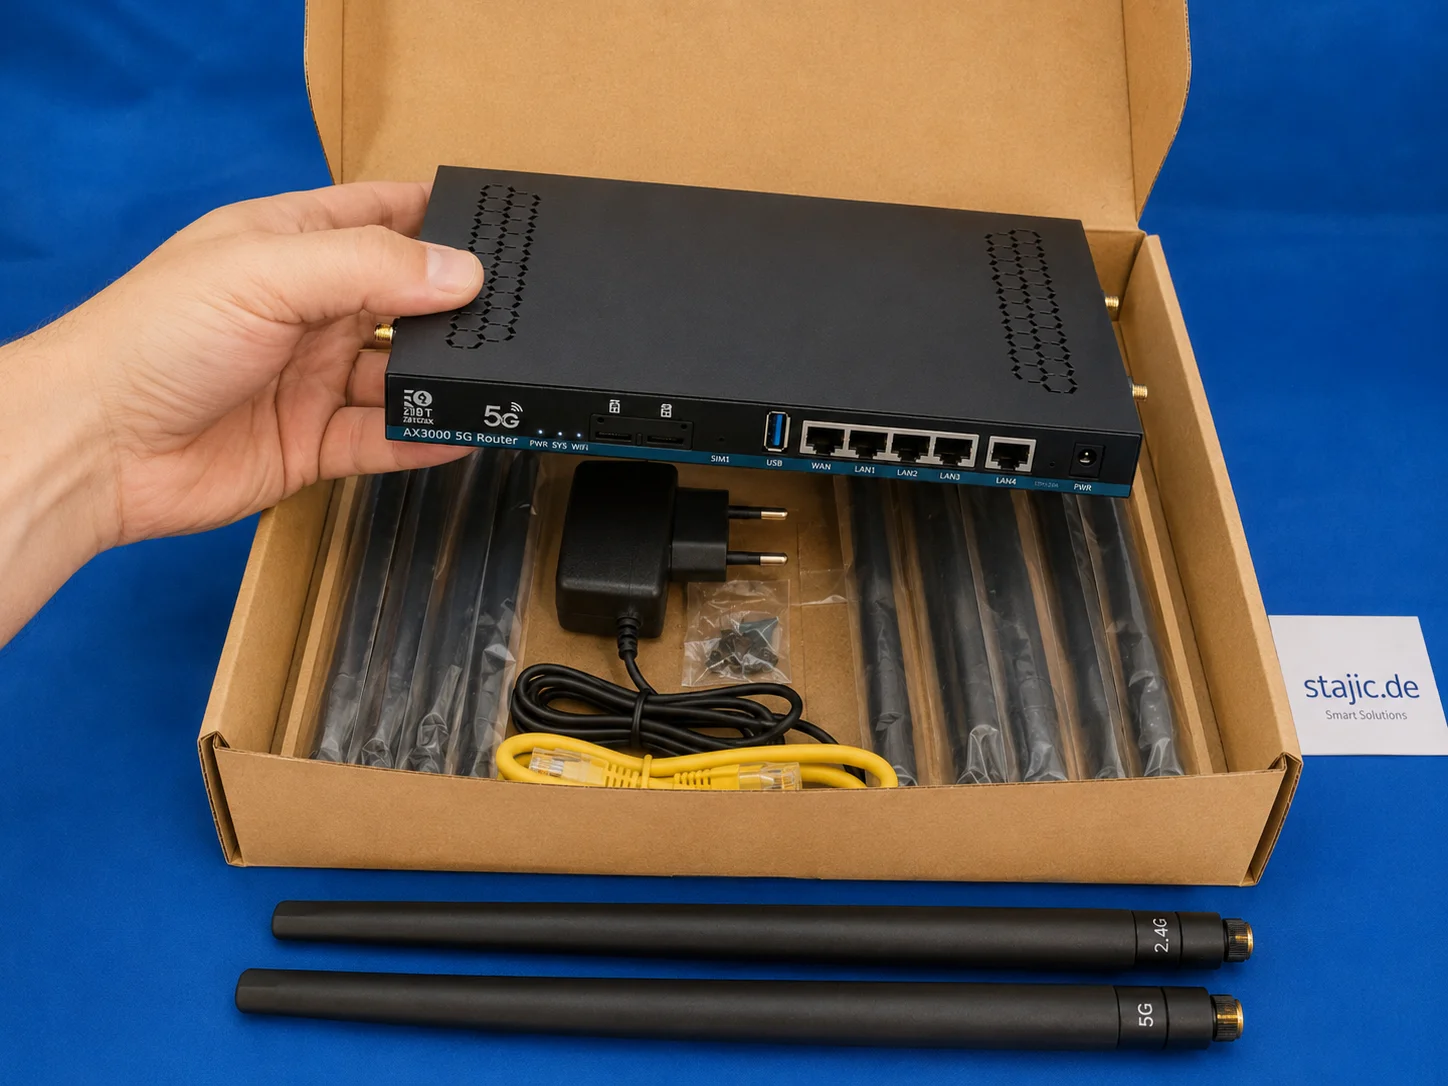
Reseña de hardware y embalaje del ZBT Z8102AX: Router fuerte, caja débil
El ZBT Z8102AX causa una primera impresión sólida como un delgado router OpenWrt 5G de metal negro con múltiples conectores de antena, ranuras para doble SIM, puertos USB, LAN/WAN y un práctico juego de accesorios. El hardware se siente útil y serio, pero el embalaje es claramente el punto débil.

Por qué más contexto puede empeorar las respuestas de la IA
Una ventana de contexto más grande no garantiza una mejor respuesta. Este artículo explica cómo la dilución de la señal, la evidencia contradictoria, el estado obsoleto, la sensibilidad a la posición y la compresión con pérdidas pueden reducir la fiabilidad de la IA—e introduce una práctica Prueba de Presión de Contexto.
Arquitectura Canónica, Diseño de URL, Lógica del Resolvedor, Especificación de API y Escalabilidad
Arquitectura de descubrimiento geobasada para portales multi-inquilino. Define URL canónicas, lógica de resolución, estrategia de caché y un modelo de lectura geográfico sin acoplamiento con CMS ni refactorización de base de datos. Diseñada para la estabilidad SEO, la escalabilidad y futuras extensiones como reservas y mapas.

¿Deberías Comprar un Router OpenWrt 5G con Firmware Antiguo? El ZBT Z8102AX como Ejemplo Práctico
Comprar un router 5G OpenWrt con firmware antiguo puede tener sentido, pero solo bajo las condiciones adecuadas. El ZBT Z8102AX muestra claramente ambos lados: el hardware es útil, el módem funciona y el router se mantuvo estable en las pruebas, pero OpenWrt 21.02, el embalaje débil y las rutas de actualización poco claras requieren una decisión de compra cuidadosa.
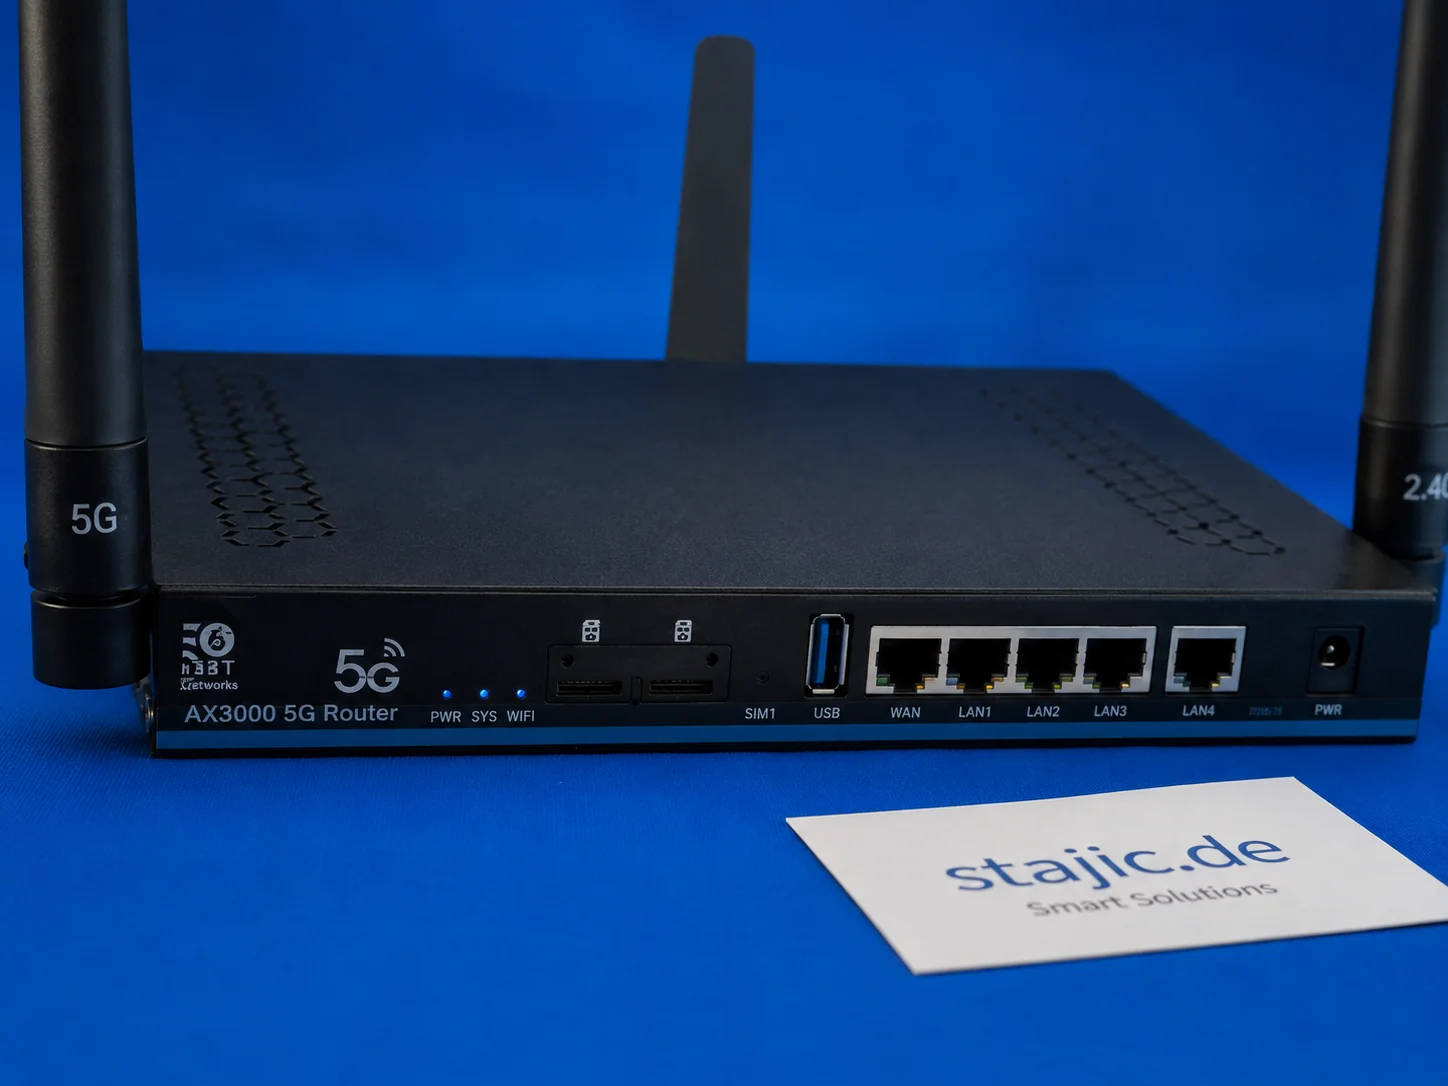
Quectel RM500U-EA en el ZBT Z8102AX: Bandas 5G, o2 Alemania y comportamiento de la señal en el mundo real
El ZBT Z8102AX utiliza un módem Quectel RM500U-EA para conectividad 4G y 5G. En la primera prueba práctica, el router se conectó con éxito a o2 Alemania con LTE Banda 3 y NR n28. El módem funciona, pero diagnósticos más profundos como RSRP, RSRQ, SINR, bloqueo de bandas y comportamiento de la celda aún necesitan pruebas adecuadas.

Agentes de uso de computadoras: por qué una demostración exitosa aún puede ser un sistema poco confiable
Los agentes de uso de computadoras ahora pueden completar impresionantes flujos de trabajo en el navegador y en el escritorio, pero una ejecución exitosa demuestra capacidad—no fiabilidad. Este artículo muestra cómo probar la repetibilidad, la robustez ambiental, el control de horizonte largo, la conciencia del estado, la verificación de resultados y la gestión segura de objetivos.

El límite de validez de la respuesta: la capa faltante entre la relevancia y las respuestas fiables de la IA
Una fuente puede ser relevante, autorizada y aun así ser incorrecta para la pregunta que se plantea. La capa que falta es la aplicabilidad: las condiciones bajo las cuales una respuesta es válida y los cambios que obligan a reconsiderarla. Este artículo presenta el Límite de Validez de la Respuesta como un patrón de diseño de fuentes para personas, sistemas de búsqueda con IA y sistemas RAG.