ComfyUI su Fedora 43: Due Ambienti Virtuali + Avvio con un Clic (Marzo 2026)
ComfyUI su Fedora 43: Due Ambienti Virtuali + Avvio con un Clic (Marzo 2026)
Data: Marzo 2026
OS: Fedora 43
Obiettivo: Mantenere due venv Python (es. 3.12 + 3.14) per compatibilità, ma avviare ComfyUI automaticamente con una configurazione pulita e leggera.
Enterprise Delivery Operating System
Questa guida fa parte della serie Enterprise Delivery Operating System. Utilizza questi hub di categoria per navigare nell'intero stack (infra → workflow → governance).
ArchitetturaArchitettura di riferimento per l'Enterprise Delivery Operating System.
DevOps e RuntimeDeployment, servizi, porte, operazioni di runtime e ripetibilità.
Strumenti AI e AutomazioneStack AI locale, orchestrazione, automazione e workflow stabili.
Sicurezza e ConformitàPermessi, hardening e impostazioni predefinite sicure per i sistemi AI locali.
Osservabilità e PrestazioniOttimizzazione delle prestazioni, monitoraggio, budgeting VRAM/RAM e stabilità.
Perché mantenere due venv?
Gli strumenti AI si evolvono rapidamente. Alcuni nodi e wheel rimangono indietro rispetto alle versioni più recenti di Python, mentre altri le richiedono.
- venv Python 3.12 → “noioso ma compatibile” (TensorRT/LW wheels/Lightning sono spesso più stabili)
- venv Python 3.14 → funzionalità più recenti, ma sono comuni wheel mancanti o problemi di importazione
Regola: non mischiare mai le installazioni tra i venv. Esegui sempre ComfyUI dal venv desiderato.
Configurazione: Uno script per venv
Crea un piccolo script di avvio che:
1) entri nella cartella ComfyUI
2) attivi il venv scelto
3) esegua ComfyUI su localhost
1) Crea un launcher per il venv Python 3.12
mkdir -p ~/.local/bin

cat > ~/.local/bin/comfyui-start-312.sh <<'EOF'
#!/usr/bin/env bash
set -euo pipefail

cd /home/x/ai/ComfyUI
source /home/x/ai/ComfyUI/.venv312/bin/activate
exec python main.py --listen 127.0.0.1 --port 8188
EOF

chmod +x ~/.local/bin/comfyui-start-312.sh
2) (Opzionale) Crea un launcher per il venv Python 3.14
cat > ~/.local/bin/comfyui-start-314.sh <<'EOF'
#!/usr/bin/env bash
set -euo pipefail

cd /home/x/ai/ComfyUI
source /home/x/ai/ComfyUI/.venv/bin/activate
exec python main.py --listen 127.0.0.1 --port 8189
EOF

chmod +x ~/.local/bin/comfyui-start-314.sh
Ora puoi eseguire entrambe le versioni senza pensarci:
- ~/.local/bin/comfyui-start-312.sh
- ~/.local/bin/comfyui-start-314.sh
Avvio automatico: servizio utente systemd (opzione migliore)
Questo avvia ComfyUI al login, lo riavvia in caso di crash e rimane minimale (niente root, niente wrapper pesanti).
1) Crea il servizio utente per 3.12
mkdir -p ~/.config/systemd/user

cat > ~/.config/systemd/user/comfyui312.service <<'EOF'
[Unit]
Description=ComfyUI (Python 3.12 venv)
After=network.target

[Service]
Type=simple
WorkingDirectory=/home/x/ai/ComfyUI
ExecStart=/home/x/.local/bin/comfyui-start-312.sh
Restart=on-failure
RestartSec=2
Environment=PYTHONUNBUFFERED=1

[Install]
WantedBy=default.target
EOF
2) Abilita + avvia
systemctl --user daemon-reload
systemctl --user enable --now comfyui312.service
systemctl --user status comfyui312.service --no-pager
3) Log (debug)
journalctl --user -u comfyui312.service -f(Se desideri anche il servizio 3.14, ripeti con comfyui314.service e l'altro script.)
GUI con un clic: Launcher desktop (apri ComfyUI nel browser)
Questo crea una voce di app nel tuo menu. Cliccandoci:
1) avvia il servizio
2) apre l'interfaccia nel tuo browser
mkdir -p ~/.local/share/applications

cat > ~/.local/share/applications/comfyui.desktop <<'EOF'
[Desktop Entry]
Type=Application
Name=ComfyUI (Local)
Comment=Start ComfyUI and open the UI
Exec=sh -lc 'systemctl --user start comfyui312.service; xdg-open http://127.0.0.1:8188'
Icon=utilities-terminal
Terminal=false
Categories=Graphics;AI;
EOF
Note per prevenire errori comuni
- Se vedi pip che installa in ~/.local/..., non sei nel venv corretto (o non lo hai attivato).
- Se un nodo fallisce con pkg_resources mancante → installa setuptools all'interno del venv scelto:source /home/x/ai/ComfyUI/.venv312/bin/activatepython -m pip install -U pip setuptools wheel
- I fallimenti dei nodi TensorRT sono normali sulle versioni più recenti di Python: se non ne hai bisogno, disabilita quella cartella di nodi personalizzati.
Prossime letture
Se vuoi approfondire, queste guide si collegano direttamente alla configurazione sopra:
Nodi ComfyUI: correzioni delle dipendenze (Lightning, pkg_resources, ffmpeg)Risolvi i comuni errori di importazione dei nodi e mantieni stabile il tuo stack ComfyUI durante gli aggiornamenti.
Due venv, due porte, zero confusioneEsegui più istanze di ComfyUI in modo pulito: porte, servizi e profili prevedibili.
Budgeting della VRAM: cosa riduce effettivamente l'OOMTattiche pratiche per la VRAM: modalità di attenzione, dimensioni dei modelli, batching e limiti reali.
Hardening dell'IA locale: permessi, sandboxing e impostazioni predefinite sicureRiduci i rischi sui sistemi IA locali: permessi dei file, isolamento dei servizi e impostazioni predefinite più sicure.
Compromessi (in breve)
servizio utente systemd
- ✅ stabile, riavvio automatico, basso overhead, pulito
- ⛔ richiede una configurazione iniziale una tantum
lanciatore desktop
- ✅ workflow con un solo clic
- ⛔ dipende ancora dall'interfaccia utente del browser
due venv
- ✅ il meglio di entrambi i mondi (compatibilità + ultime versioni)
- ⛔ è necessario mantenere separati porte/servizi per evitare confusione
Related Articles
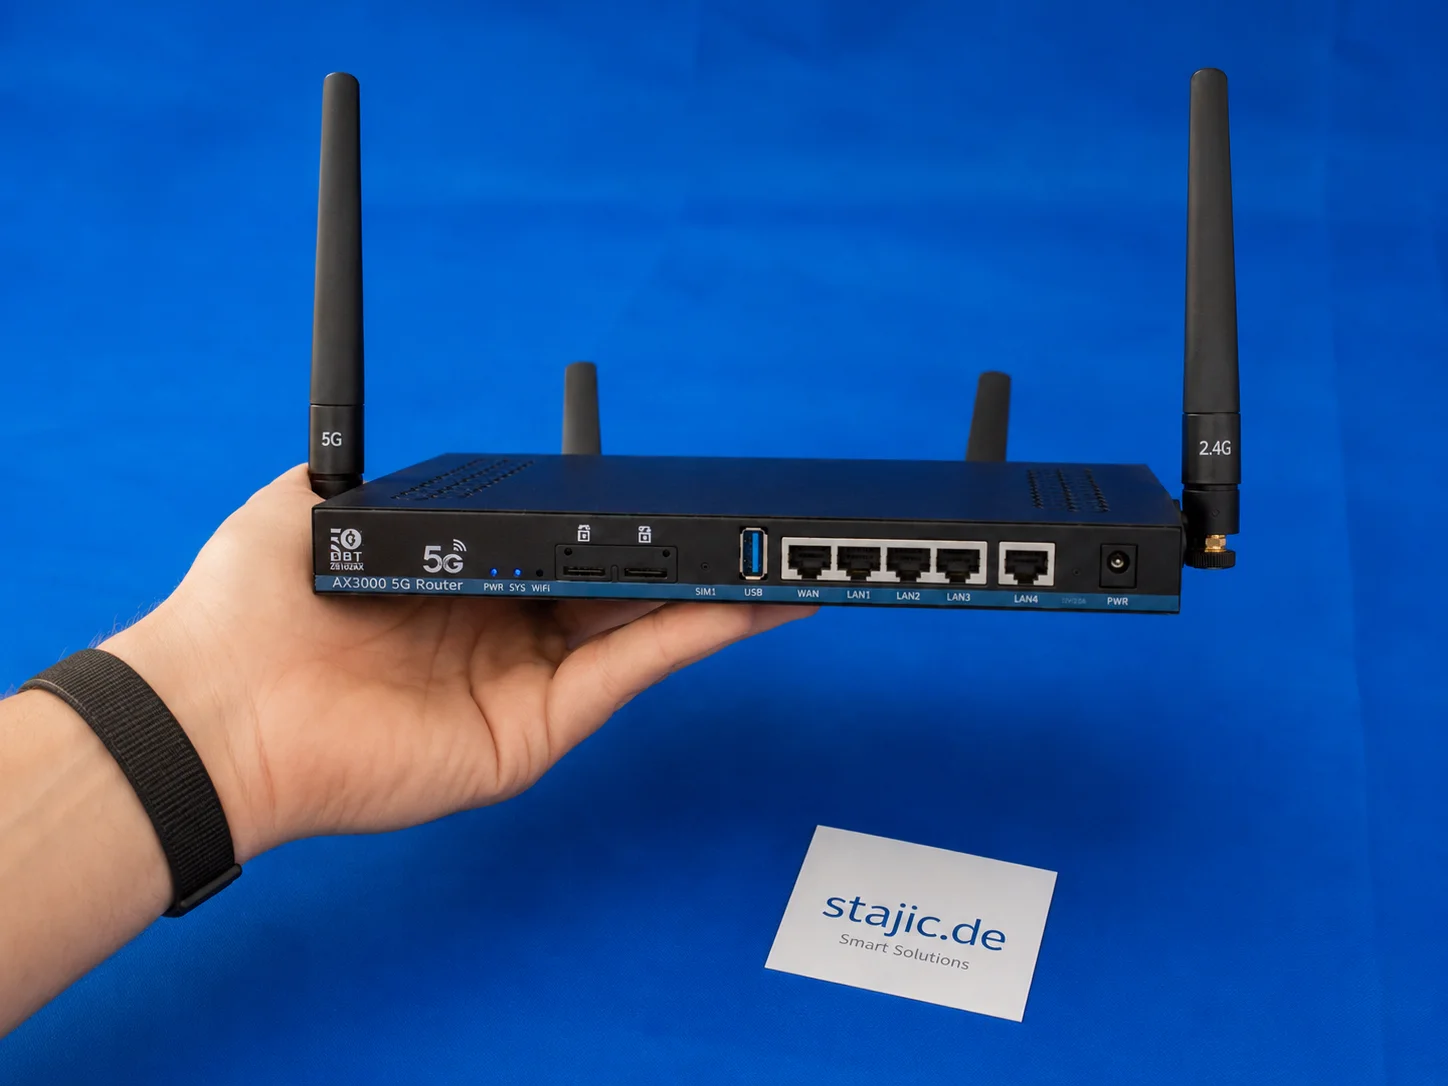
Dovresti Acquistare un Router OpenWrt 5G con Firmware Vecchio? ZBT Z8102AX come Esempio Pratico
Acquistare un router 5G OpenWrt con firmware più vecchio può avere senso, ma solo nelle giuste condizioni. Lo ZBT Z8102AX mostra chiaramente entrambi i lati: l'hardware è utile, il modem funziona e il router è rimasto stabile durante i test, ma OpenWrt 21.02, il packaging debole e i percorsi di aggiornamento poco chiari richiedono una decisione d'acquisto attenta.
Guida completa a Evaluation Harness: Padroneggiare la valutazione delle prestazioni degli LLM
Questa guida fornisce una panoramica dettagliata di Evaluation Harness, un framework essenziale per valutare rigorosamente le capacità dei modelli linguistici di grandi dimensioni (LLM) nelle pipeline LLMOps aziendali. Scopri la configurazione, le best practice e le tecniche avanzate per garantire un benchmarking e un'ottimizzazione dei modelli affidabili.
La memoria dell'agente IA non è RAG: come separare memoria, recupero, stato e contesto
Memoria dell'agente, RAG, stato e contesto vengono spesso usati come se fossero intercambiabili. Non lo sono. Questo pratico modello architetturale separa i quattro livelli, mostra dove si colloca ciascuno e spiega cosa si rompe quando i sistemi li fanno collassare in uno solo.
Invarianza del prompt: la conclusione sopravvive al prompt?
Una metodologia pratica per verificare se una conclusione dell'IA dipenda dal modo in cui è stato inquadrato un problema. Prompt Invariance confronta formulazioni originali, cieche, invertite e avversarie, mantenendo controllata la struttura delle evidenze.
IA agentica spiegata: quando un sistema di IA può pianificare, usare strumenti e agire
L'IA agentica utilizza modelli all'interno di cicli di esecuzione a più passaggi, in cui possono scegliere strumenti, osservare i risultati, aggiornare lo stato e adattare l'azione successiva entro limiti espliciti di runtime e di autorizzazione.
Affidabilità degli Agenti AI: Perché la Risposta Finale Non è Sufficiente
Un output corretto non dimostra un ragionamento corretto, un'esecuzione sicura o un sistema affidabile.
Enterprise: Inizia qui: La tua porta d'accesso all'eccellenza operativa
Nuovo sulla nostra piattaforma enterprise? Questa guida fornisce un percorso di onboarding strutturato, dai modelli di riferimento fondamentali a playbook, runbook e assessment operativi progettati per un'implementazione fluida.
Oltre l'ingegneria dei prompt: una metodologia per un ragionamento AI più affidabile
I grandi modelli linguistici non falliscono necessariamente perché mancano di capacità di ragionamento. Spesso falliscono perché il processo di ragionamento non è sufficientemente vincolato, messo in discussione o verificato. Questo articolo presenta una metodologia indipendente dal dominio che trasforma il prompting in un processo epistemico strutturato: separare i fatti dalle assunzioni, generare ipotesi concorrenti, testare le controprove, applicare la falsificazione e verificare se le conclusioni rimangono stabili sotto inquadrature alternative. L'obiettivo non è rendere il modello "meno d'accordo", ma rendere le sue conclusioni meno dipendenti dall'inquadratura iniziale dell'utente.
Architettura Multi-Tenant di Livello Enterprise per una Piattaforma Internazionale
Loving Rocks è una piattaforma per matrimoni di livello enterprise progettata con una vera architettura multi-tenant, database isolati per tenant e internazionalizzazione integrata per scalabilità globale, sicurezza e stabilità operativa a lungo termine.
Che cos'è un AI Solution Architect? Confini del sistema, responsabilità e compromessi
Un Solution Architect AI trasforma i requisiti aziendali in un sistema AI pronto per la produzione, attraverso dati, modelli, strumenti, sicurezza, runtime, valutazione e operazioni.
Qwen 3.6 in produzione: Runbook di rilascio, Rollback AI e Versionamento LLMOps
Qwen 3.6 non è solo un altro aggiornamento del modello. È un evento di rilascio, uno scenario di rollback e un problema di versionamento allo stesso tempo. Questo articolo spiega come Qwen 3.6 dovrebbe essere gestito in produzione attraverso la disciplina LLMOps, la tracciabilità dei prompt e dei modelli, il rollout controllato e la prontezza al rollback basata sull'evidenza.
Harness per agenti gestito vs loop per agenti self-hosted: cosa si guadagna, cosa si perde
“Agente self-hosted” può indicare architetture molto diverse. Questa guida separa l'harness gestito, l'ambiente di esecuzione self-hosted e il loop dell'agente completamente autogestito—e mostra quale perimetro di controllo serve effettivamente ai team.