
Harness de agente gestionado vs. bucle de agente autohospedado: lo que ganas, lo que pierdes
La frase «agente autoalojado» oculta ahora al menos tres arquitecturas diferentes. Puede utilizar un harness gestionado con cómputo alojado por OpenAI, un harness gestionado conectado a infraestructura que usted opera, o ejecutar el harness y el bucle del agente usted mismo. Esas elecciones tienen implicaciones muy distintas en cuanto a control, recuperación, gestión del contexto, seguridad, latencia y carga operativa.
El error: tratar el autoalojamiento como una sola decisión
En el software convencional, «autoalojado» suele significar que la aplicación se ejecuta en una infraestructura que usted controla. Los sistemas de agentes complican esa definición porque el entorno de ejecución puede dividirse. El bucle de modelo y herramientas puede ejecutarse en un lugar mientras que la ejecución del código, los archivos y el acceso a redes privadas ocurren en otro.
La arquitectura actual de la API de Agents de OpenAI hace explícita esta división: OpenAI ejecuta el harness, mientras que el entorno de ejecución puede estar ausente, alojado por OpenAI o autoalojado. Por lo tanto, un entorno autoalojado no significa que el bucle del agente esté autoalojado.
Esta distinción es importante porque muchos equipos eligen un entorno de ejecución más complejo de lo que necesitan. Desean acceso a redes privadas o paquetes personalizados, concluyen que todo el agente debe ser autoalojado y, accidentalmente, asumen la responsabilidad de la gestión del contexto, la orquestación, la recuperación y el ciclo de vida que podrían haber permanecido gestionados.
Tres arquitecturas a las que a menudo se llama «autoalojadas»
| Arquitectura | ¿Quién ejecuta el harness? | Dónde se ejecutan el código y los archivos | De qué es usted responsable principalmente |
|---|---|---|---|
| Harness gestionado + entorno gestionado | Plataforma | Sandbox alojado por la plataforma | Aplicación, herramientas, lógica de producto, autorización |
| Harness gestionado + entorno autoalojado | Plataforma | Su contenedor, máquina virtual, portátil, nube privada u otro cómputo | Aprovisionamiento del entorno, redes, archivos y ciclo de vida; la plataforma sigue siendo propietaria del harness |
| Harness / bucle de agente operado por usted | Usted | El entorno de su elección | Proceso del harness, orquestación, estrategia de contexto, alojamiento, recuperación, ejecución y ciclo de vida de la aplicación |
El modelo de dos planos
Separe el plano del harness del plano de ejecución
| Plano | De qué se encarga | Preguntas a formular | |
|---|---|---|---|
| Plano del harness | |||
| Plano de ejecución | |||
| Plano de aplicación |
Harness gestionado: lo que realmente gana
Un harness gestionado elimina más que un bucle while. La API actual de Agents de OpenAI gestiona sesiones, orquestación, compactación de contexto y recuperación. El trabajo de Anthropic sobre agentes gestionados describe la misma motivación general: los harnesses contienen supuestos sobre el comportamiento de los modelos, y esos supuestos deben evolucionar a medida que los modelos mejoran.
Eso significa que la ventaja no se reduce a tener menos líneas de código. La plataforma puede actualizar el comportamiento en tiempo de ejecución, el manejo de contexto a largo plazo, la coordinación de subagentes y la recuperación sin requerir que cada equipo de aplicaciones reconstruya dichos mecanismos.
- Menos código de orquestación a cargo de la aplicación.
- Comportamiento gestionado de sesiones duraderas.
- Compactación y recuperación de contexto gestionadas.
- Un entorno de ejecución que puede evolucionar con las capacidades del modelo.
- Adopción más sencilla de características nativas de la plataforma para subagentes y agentes de larga duración.
- Carga operativa potencialmente menor para equipos cuya diferenciación no reside en el propio harness.
Harness gestionado: a qué se renuncia
Delegar el harness también delega parte del control. Tu aplicación ya no es dueña de cada detalle de la iteración, la estrategia de contexto, la orquestación y la evolución del entorno de ejecución. Una actualización de la plataforma puede mejorar el sistema, pero también puede cambiar comportamientos de los que tu producto dependía implícitamente.
Esto genera un tipo diferente de requisito de ingeniería: evaluaciones sólidas, límites de producto explícitos y una capa de integración que evite que el comportamiento de la sesión gestionada se convierta en la fuente de verdad de tu negocio.
| Compromiso del harness gestionado | Qué significa a nivel operativo |
|---|---|
| Menor control del bucle | No puedes asumir que cada detalle de la orquestación está definido por la aplicación |
| Evolución de la plataforma | El comportamiento del harness puede mejorar o cambiar sin que cambie tu código |
| Ciclo de vida específico del proveedor | Las sesiones, los eventos y la semántica de recuperación pasan a formar parte de la superficie de integración |
| Límite de observabilidad | Las trazas de la plataforma deben combinarse con los datos de auditoría de la aplicación |
| Coste de portabilidad | Migrar a otro harness en el futuro puede requerir más que simplemente cambiar los endpoints del modelo |
Entorno de ejecución autohospedado: la arquitectura intermedia
El modelo de entorno autohospedado de OpenAI es importante porque desacopla la computación privada de la propiedad del harness. La plataforma sigue ejecutando el harness de Codex, mientras que un ejecutor corre dentro de tu entorno y recibe comandos a través de una conexión saliente.
Tú controlas el aprovisionamiento, los archivos, las dependencias, el acceso a la red y la limpieza. Por lo tanto, el harness puede operar contra infraestructura privada o software personalizado sin requerir que todo el entorno de ejecución del agente se traslade a tu aplicación.
El coste es la responsabilidad del ciclo de vida. Tu aplicación debe mapear sesiones a computación, evitar aprovisionamientos duplicados, reconectar entornos, coordinar el apagado y preservar cualquier archivo que deba sobrevivir al entorno.
Cuándo es suficiente la ejecución autohospedada
- El agente necesita acceso a una VPC privada o a un servicio interno.
- El agente necesita binarios personalizados, paquetes, controladores o software del sistema.
- La carga de trabajo debe ejecutarse en hardware o cuentas de nube que tú controlas.
- Los archivos deben permanecer dentro de un entorno controlado.
- Necesitas tu propio proveedor de sandboxing o modelo de aislamiento.
- Deseas una orquestación gestionada por la plataforma pero una ejecución controlada por tu infraestructura.
Cuándo podrías necesitar gestionar también el harness
Ser propietario del harness se justifica cuando el propio harness forma parte de la diferenciación de tu producto o de su conjunto de restricciones. La descripción general actual del runtime de OpenAI posiciona el SDK de Codex para ejecutar el harness de Codex en infraestructura que tú operas, mientras que Responses es la opción de nivel inferior cuando deseas ser dueño del bucle del agente por ti mismo.
La clave consiste en identificar un requisito que resida genuinamente en el plano del harness, no en el plano de ejecución.
| Requisito | ¿Problema del plano de ejecución o del plano del harness? | Dirección probable |
|---|---|---|
| Acceso a base de datos privada | Plano de ejecución | Harness gestionado + entorno autohospedado puede ser suficiente |
| Paquetes de Linux personalizados | Plano de ejecución | Harness gestionado + entorno autohospedado |
| Hardware de GPU personalizado | Plano de ejecución | Harness gestionado + entorno autohospedado donde esté admitido |
| Lógica de detención de agente personalizada | Plano del harness | Harness autooperado / bucle personalizado |
| Enrutamiento de modelos entre proveedores en cada paso | Plano del harness | Bucle personalizado o harness que tú operas |
| Algoritmo personalizado de compactación de contexto | Plano del harness | Harness autooperado si el runtime gestionado no puede exponerlo |
| Semántica de orquestación determinista requerida por el producto | Plano del harness | Harness autooperado o bucle personalizado estrictamente controlado |
| Despliegue de producto exclusivamente local sin dependencia de un harness gestionado | Plano del harness + plano de ejecución | Runtime autooperado |
La prueba de escalada de control
Utiliza la arquitectura menos autohospedada que satisfaga el requisito real. Escala el control capa por capa.
Prueba de escalada de control
La carga operativa crece de forma no lineal cuando eres dueño del harness
Un bucle autooperado parece sencillo en una demo: llamar al modelo, inspeccionar la llamada a la herramienta, ejecutar la herramienta, añadir el resultado y repetir. La producción añade estado duradero, reintentos, eventos duplicados, cancelaciones, aprobaciones, desbordamiento de contexto, tiempos de espera de herramientas, reinicios de procesos, persistencia de trazas, contrapresión, trabajo concurrente y recuperación tras efectos secundarios parciales.
La investigación de Anthropic sobre agentes de ejecución prolongada demuestra reiteradamente que el diseño del entorno de ejecución (harness) afecta sustancialmente al rendimiento. Su trabajo en el desarrollo de aplicaciones de ejecución prolongada utiliza planificación explícita, artefactos estructurados y agentes evaluadores, ya que los bucles ingenuos tienden a perder el progreso o a terminar prematuramente. Por tanto, el harness es lógica de producción, no mera fontanería.
| Si gestionas tu propio harness, también necesitas una respuesta para | Por qué es importante |
|---|---|
| Estado de sesión duradero | Los procesos se reinician; el trabajo de larga duración debe reanudarse correctamente |
| Compactación de contexto | El historial acaba superando el contexto de trabajo práctico |
| Idempotencia de herramientas | Los reintentos no deben repetir efectos secundarios irreversibles |
| Cancelación e interrupción | Los usuarios y los sistemas necesitan detener o redirigir el trabajo |
| Recuperación tras ejecución parcial | Una herramienta puede ejecutarse con éxito incluso si el agente nunca recibe el resultado |
| Concurrencia | Múltiples tareas, workers o agentes pueden interactuar con un estado compartido |
| Observabilidad | El resultado final no es suficiente para depurar fallos en tiempo de ejecución |
| Versionado | Las actualizaciones del harness pueden cambiar el comportamiento incluso cuando los prompts se mantienen constantes |
| Evaluación | Los cambios en el runtime requieren pruebas de regresión en trayectorias representativas |
Límite de seguridad: autohospedar el cómputo no hace que el agente sea privado automáticamente
Un entorno de ejecución autohospedado controla dónde se ejecutan los comandos y dónde residen los archivos, pero el harness gestionado y la interacción con el modelo siguen cruzando el límite del servicio. Por tanto, los equipos deben mapear los flujos de datos de forma explícita en lugar de utilizar «autohospedado» como sinónimo de privacidad.
El ejecutor autohospedado de OpenAI utiliza credenciales de entorno restringidas y conexiones salientes. Se trata de un aislamiento útil, pero tu aplicación sigue necesitando sus propias reglas para secretos, exposición a redes privadas, aislamiento entre usuarios y entornos, retención de archivos, autorización de herramientas y clasificación de datos.
Latencia y coste: el control puede trasladar los cuellos de botella en lugar de eliminarlos
El autohospedaje puede reducir algunos costes en la ruta de datos o de inicio de entornos, pero también puede añadir tiempo de aprovisionamiento, ciclo de vida de WebSockets, arranques en frío, limpieza de sandboxes, infraestructura de observabilidad y sobrecarga de ingeniería. Un entorno gestionado puede costar más por unidad de cómputo y, al mismo tiempo, resultar más económico de operar con volúmenes bajos o irregulares.
La comparación adecuada es el coste total del sistema: uso de modelos y herramientas, tiempo de entorno, infraestructura, esfuerzo de ingeniería, carga de guardias (on-call), recuperación de fallos y el coste de iterar más lentamente.
Matriz de decisión para producción
| Restricción | Harness gestionado + entorno gestionado | Harness gestionado + entorno autohospedado | Harness / bucle autooperado |
|---|---|---|---|
| Vía más rápida a producción | Fuerte | Moderada | Más débil |
| Ejecución en red privada | Débil / depende del diseño de conectividad | Fuerte | Fuerte |
| Paquetes personalizados / software de sistema | Moderado | Fuerte | Fuerte |
| Control a nivel de harness | Bajo | Bajo | El más alto |
| Carga operativa | La más baja | Media | La más alta |
| Portabilidad | La más baja | Media | Potencialmente la más alta si se diseña intencionadamente |
| Control de la estrategia de contexto | Gestionado por la plataforma | Gestionado por la plataforma | Controlado por la aplicación |
| Control de la infraestructura de ejecución | Bajo | Alto | Alto |
| Capacidad para beneficiarse de actualizaciones del harness gestionado | La más alta | La más alta | Asumes la adopción |
| Mejor encaje | Equipos que se diferencian en la capa de producto/herramientas | Equipos que necesitan cómputo privado/personalizado sin asumir la orquestación | Equipos cuya semántica de tiempo de ejecución es en sí misma un requisito |
El modelo híbrido no es un compromiso: a menudo es la arquitectura limpia
Un harness gestionado con ejecución autohospedada no es estar «a medio autohospedar». Es una separación intencionada de responsabilidades. La plataforma asume la complejidad del runtime de agentes de largo alcance, mientras que tu infraestructura controla la ejecución, la conectividad privada y los archivos.
Ese límite se asemeja al de otras arquitecturas en la nube: plano de control gestionado, plano de datos o de ejecución controlado por el cliente. La labor de diseño fundamental consiste en definir el contrato entre ambos: identidad de la sesión, identidad del entorno, credenciales, archivos, permisos de herramientas, eventos del ciclo de vida y limpieza.
¿Qué cambiaría esta respuesta?
La recomendación cambia si los harnesses gestionados ofrecen un control sustancialmente mayor sobre el runtime, si los harnesses autohospedados incorporan primitivas más sencillas de sesiones duraderas y recuperación, o si la normativa exige que todo el bucle del agente y la interacción con el modelo permanezcan dentro de la infraestructura que tú operas.
También cambia con la capacidad del modelo. Anthropic señala explícitamente que los supuestos del harness pueden quedar obsoletos a medida que los modelos mejoran. Un mecanismo de control que es esencial hoy en día puede volverse innecesario más adelante, mientras que una nueva capacidad del modelo puede generar un nuevo requisito de gobernanza.
Limitaciones
Este artículo separa las responsabilidades de la arquitectura; no afirma que un modelo de alojamiento sea universalmente más seguro, más económico o más confiable. Esos resultados dependen de la implementación, la carga de trabajo, los requisitos de cumplimiento, las habilidades del equipo y el comportamiento del proveedor.
La API de OpenAI Agents todavía está en fase beta pública, y los productos de agentes gestionados de diferentes proveedores exponen diferentes límites. El modelo de dos planos tiene como objetivo ayudar a comparar esas arquitecturas sin asumir que todos los proveedores utilicen términos idénticos.
Conclusión
La pregunta útil no es “¿Deberíamos alojar el agente nosotros mismos?” Es: ¿Qué plano necesitamos controlar realmente?
Si el requisito es cómputo privado, paquetes personalizados, archivos locales o acceso a la red interna, aloje el plano de ejecución y mantenga el harness gestionado. Si el requisito son las semánticas de orquestación, la estrategia de contexto, el control del proveedor o el propio ciclo de vida del runtime, entonces asumir la propiedad del harness puede estar justificado. Aumente el control solo en la medida en que el requisito lo exija.
Preguntas frecuentes
Harnesses gestionados y runtimes de agentes autoalojados
¿Un entorno autoalojado de la API de OpenAI Agents es un agente autoalojado?
¿Cuándo es suficiente un entorno autoalojado?
¿Cuándo debería ejecutar el harness yo mismo?
¿El autoalojamiento mejora automáticamente la seguridad?
¿Cuál es el principal costo operativo de ser dueño del bucle del agente?
Glosario
Términos clave de arquitectura
- Plano del harness
- La capa del runtime del agente responsable de la ejecución del bucle, la orquestación, la gestión del contexto, la continuidad de la sesión y la recuperación.
- Plano de ejecución
- El entorno en el que se ejecutan los comandos, corre el código y se accede a los archivos, paquetes y recursos locales.
- Harness gestionado
- Un harness de agente cuyo runtime, gestión de sesiones y orquestación son operados por un proveedor de plataforma.
- Entorno autoalojado
- Cómputo y archivos operados por el propietario de la aplicación mientras que un harness de agente independiente puede permanecer gestionado en otro lugar.
- Harness autooperado
- Un runtime de agente cuyo bucle, alojamiento, estrategia de contexto y ciclo de vida son operados por el equipo de la aplicación.
- Prueba de escalamiento de control
- Un método de decisión que incrementa la propiedad de la infraestructura y el runtime solo cuando un requisito no puede satisfacerse en una capa de menor control.
Fuentes primarias y lecturas adicionales
OpenAI — Arquitectura de la API de AgentsSeparación actual entre el harness alojado, el entorno de ejecución y el servidor de aplicaciones.
OpenAI — Sandboxes autoalojadosCómo los entornos de ejecución operados por el cliente se conectan al harness gestionado y qué responsabilidades del ciclo de vida permanecen en la aplicación.
OpenAI — Ciclo de vida del sandboxAprovisionamiento, reconexión, prevención de entornos duplicados y responsabilidades de limpieza para el cómputo autoalojado.
OpenAI — Opciones de runtime de agentesComparación actual de la API de Agents, el SDK de Codex y la API de Responses según las responsabilidades gestionadas frente a las operadas por la aplicación.
OpenAI — Codex como plataformaHarness de Codex de código abierto y capas de integración para aplicaciones que desean un control de runtime más profundo.
Anthropic — Escalando agentes gestionados: Desacoplando el cerebro de las manosAnálisis de la arquitectura de agentes gestionados y por qué los supuestos del harness deben evolucionar con la capacidad del modelo.
Anthropic — Arneses eficaces para agentes de ejecución prolongadaLecciones de ingeniería que demuestran que el rendimiento de los agentes de ejecución prolongada depende sustancialmente del diseño del arnés y de los artefactos persistentes.
Related Articles
Optimización para motores de búsqueda: El flujo de trabajo confiable para los primeros puestos
Análisis detallado de la optimización para motores de búsqueda (SEO), sus fundamentos técnicos, el papel de los rastreadores web y los pasos estratégicos para alcanzar las primeras posiciones orgánicas.

Dominando el flujo de trabajo SEO: Estrategias de optimización esenciales para el crecimiento orgánico
Un flujo de trabajo SEO estructurado es crucial para un crecimiento orgánico sostenible. Aprende las diez estrategias fundamentales, desde la investigación de palabras clave y la optimización técnica hasta la calidad del contenido y el análisis de rendimiento.
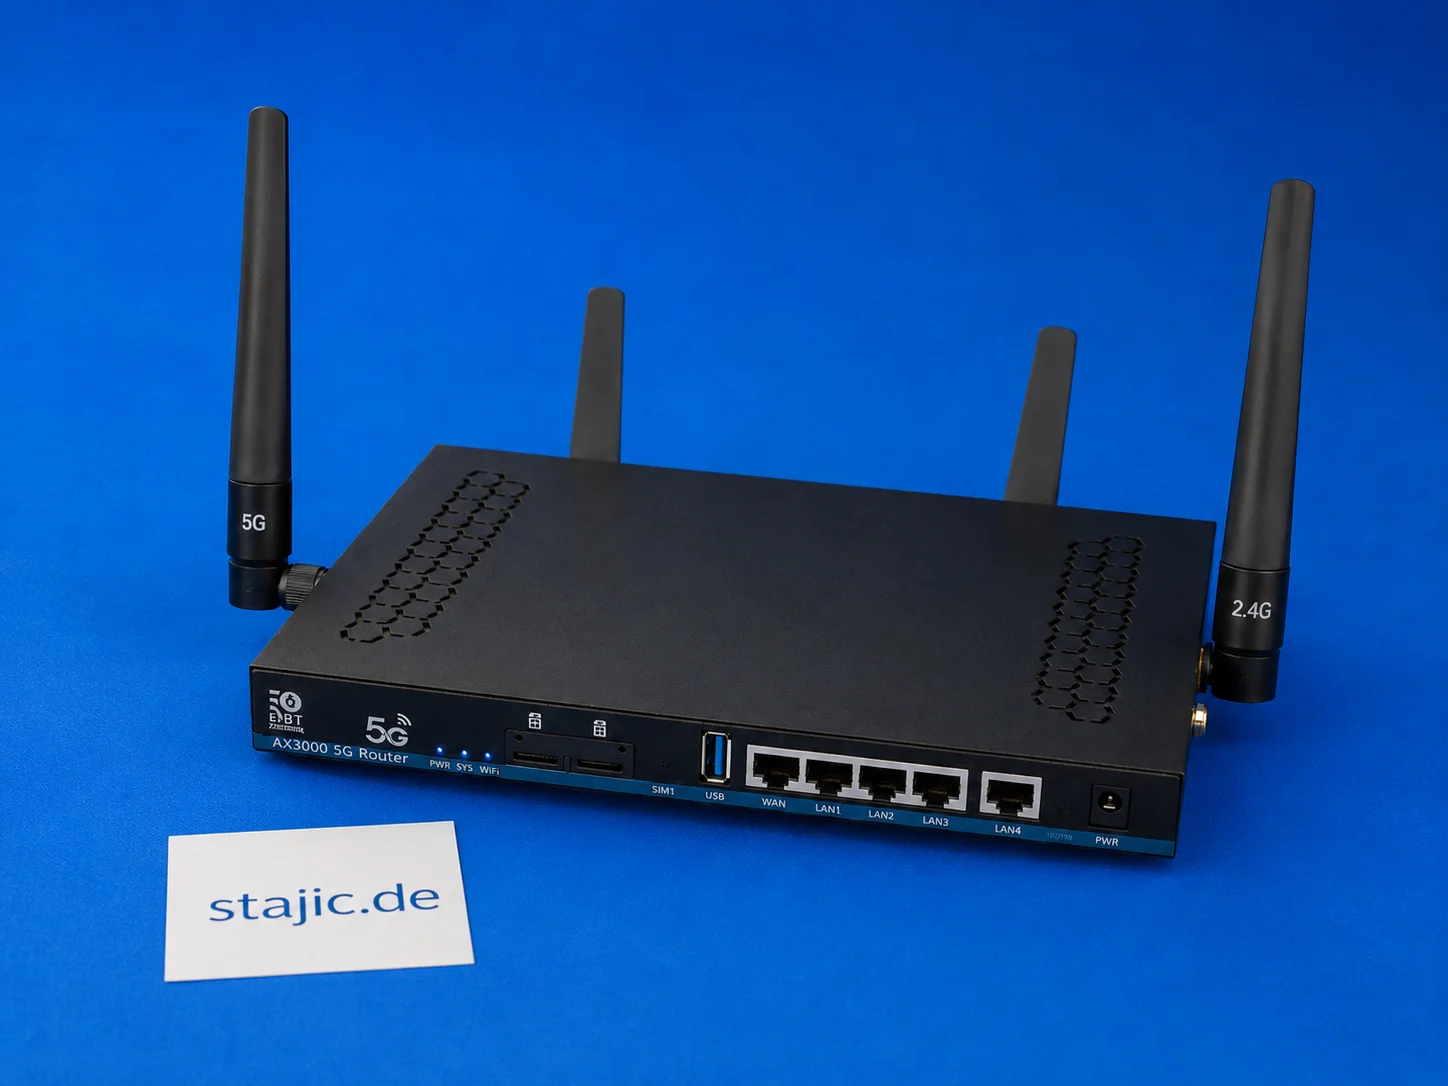
Conmutación por error de doble SIM del ZBT Z8102AX: qué funciona, qué falta y qué necesita un mejor firmware
El ZBT Z8102AX es un router OpenWrt 5G de doble SIM, pero el hardware de doble SIM por sí solo no es lo mismo que una conmutación por error inteligente. El router reconoce la SIM y se conecta correctamente, pero el cambio automático, la recuperación del módem, las decisiones basadas en la señal y una lógica de conmutación por error limpia aún necesitan pruebas más profundas.
Guía completa de Evaluation Harness: Dominando la evaluación del rendimiento de LLM
Esta guía proporciona un recorrido detallado de Evaluation Harness, un marco de trabajo esencial para evaluar rigurosamente las capacidades de los modelos de lenguaje extensos (LLM) en los pipelines de LLMOps empresariales. Conozca la configuración, las mejores prácticas y las técnicas avanzadas para garantizar una evaluación comparativa y optimización de modelos confiables.

RAG falló — ¿Pero qué capa falló realmente? Un método de diagnóstico
Cuando una respuesta RAG es incorrecta, culpar a la recuperación o al modelo es demasiado vago. Este método de diagnóstico aísla la cobertura de fuentes, la construcción de consultas, la recuperación, el ranking, el ensamblaje del contexto, la generación, la atribución de evidencia y la actualidad, de modo que el fallo real puede reproducirse y corregirse.

Ollama no es el producto: Construcción de aplicaciones de LLM abiertos listas para producción
Ejecutar un modelo local con Ollama es fácil. Construir una aplicación Open-LLM lista para producción es más difícil: requiere RAG, control de acceso, abstracción de proveedores, evaluación, registro, disciplina de despliegue y una capa de aplicación controlada alrededor del modelo.