
Von Rohdaten zu verifizierbarem KI-Kontext: Eine praktische Architektur für agentenbereite Informationen
Die meisten KI-Projekte beginnen zu spät in der Pipeline. Sie starten mit einem Modell, einem Prompt oder einer Retrieval-Schicht und entdecken erst später, dass die zugrunde liegenden Daten inkonsistent, dupliziert, veraltet, privat oder nicht auf eine zuverlässige Quelle zurückführbar sind.
Eine dauerhaftere Architektur beginnt vor dem Retrieval. Die erste Aufgabe besteht darin, zu entscheiden, was ein Informationsobjekt tatsächlich ist, woher es stammt, zu welcher Identität es gehört, ob eine andere Quelle ihm widerspricht und unter welchen Bedingungen es noch gültig ist.
Was das wirklich bedeutet
Das Ziel ist nicht, eine weitere Wissensdatenbank voller Text zu erstellen. Das Ziel ist, Informationen zu schaffen, die nützlich bleiben, wenn der Konsument kein Mensch mehr ist, der eine Website durchsucht, sondern eine Anwendung oder ein KI-Agent, der eine Entscheidung trifft.
Von heterogenen Daten zu kontrolliertem Kontext
Das einfachste Beispiel
Stellen Sie sich drei Datenquellen vor, die dasselbe Gerät beschreiben. Ein Lieferant gibt an, es habe 32 GB Speicher, ein älteres PDF sagt 16 GB, und der Hersteller-Feed sagt 32 GB für Hardware-Revision 4. Eine normale Anreicherungspipeline wählt möglicherweise einen Wert und überschreibt die anderen. Eine verifizierbare Pipeline hält die Uneinigkeit sichtbar, bis Identität und Revision geklärt sind.
Das Ergebnis ist nicht einfach Speicher = 32 GB. Es ist eher: Wert 32 GB, Quelle Hersteller-Feed, Revision 4, Markt EU, zu einem bekannten Zeitpunkt beobachtet, widersprüchliche ältere Quelle vorhanden, aktueller Status für die geklärte Revision verifiziert.
Wo das Beispiel nicht mehr funktioniert
Echte Geschäftsdaten sind selten so sauber. Produktnamen driften, Identifikatoren fehlen, PDFs verwenden unterschiedliche Terminologie, Felder ändern ihre Bedeutung zwischen Märkten, und private Mandantendaten dürfen nicht in den Kontext eines anderen Mandanten gelangen. Deshalb reicht Normalisierung allein nicht aus.
Ein wiederverwendbares Informationsobjekt
| Feld | Zweck |
|---|---|
| Identität | Zu welcher Entität oder Version gehört diese Aussage? |
| Wert | Was wird tatsächlich behauptet? |
| Quelle | Woher stammt sie? |
| Status | Verifizierte Quelle, Händlerangabe, benutzerbereitgestellt, abgeleitet, Schlussfolgerung, unbekannt oder widersprüchlich |
| Beobachtet am | Wann wurde es gesehen? |
| Gültigkeit | Wo, wann und für welche Version gilt es? |
| Rechte | Darf diese Quelle gespeichert, wiederverwendet oder weitergegeben werden? |
| Mandant | Welcher Kunde oder Dateninhaber darf sie nutzen? |
Warum RAG nicht der erste Schritt ist
Retrieval kann nur abrufen, was indexiert wurde. Wenn widersprüchliche, veraltete oder rechtlich eingeschränkte Daten ohne Governance indexiert werden, kann RAG die Antwort besser erscheinen lassen, während es die zugrunde liegende Entscheidung weniger zuverlässig macht.
Eine sicherere Reihenfolge ist: Rechte-Gate → Quellenklassifizierung → Identitätsauflösung → Aussagenextraktion → Herkunft → Konflikterkennung → Nachweisspeicher → Retrieval → Schlussfolgerung.
Agent-bereit bedeutet nicht agent-gesteuert
Ein Agent sollte kontrollierten Kontext erhalten, nicht uneingeschränkte Autorität. Das Modell kann über die verfügbaren Informationen schlussfolgern, aber es sollte nicht erlaubt sein, fehlende Produktfakten zu erfinden, verbindliche Einschränkungen zu lockern, Quellenrechtsregeln zu umgehen oder Unsicherheit in Gewissheit zu verwandeln.
Warum dies über eine Domäne hinaus wichtig ist
Dieselbe Architektur gilt für technische Produkte, Eventplanung, Softwaredokumentation, Lieferantenkataloge, internes Wissen und Handel. Die Domänenregeln ändern sich, aber das Kernproblem bleibt: Identität, Herkunft, Konflikte, Gültigkeit und kontrollierte Wiederverwendung.
Was würde diese Architektur verändern?
Die Architektur sollte einfacher werden, wenn das Quellsystem bereits kanonische Identifikatoren, strikte Versionierung und vertragliche Datenqualität bietet. Sie sollte strenger werden, wenn Entscheidungen regulierte Produkte, Sicherheit, private Daten oder rechtlich sensible Ergebnisse betreffen.
Fazit
Die nützliche Einheit für zukünftige KI-Systeme ist nicht nur ein Dokument oder ein Textabschnitt. Es ist ein verifizierbares Informationsobjekt mit Identität, Herkunft, Status, Konflikten und einer Gültigkeitsgrenze. Das ist die Ebene, die Portalen, Geschäftssystemen und Agenten ermöglicht, dasselbe Wissen wiederzuverwenden, ohne vorzugeben, dass unsichere Daten sicher sind.
Related Projects
Von der Vision zum Wert: Maximierung des POS-ROI durch konsistente CI-Erstellung und strategisches Branding
Im modernen Einzelhandel erfordert die Überbrückung der Lücke zwischen kreativer Vision und finanziellem Wert die Abstimmung der Corporate Identity (CI) auf den Point of Sale (POS). Diese Fallstudie untersucht das Framework zur Eliminierung kognitiver Reibung, um den ROI zu steigern.
Vom Global Business bis in die Küche — Enterprise Media OS, das gelassen skaliert (stajic.de + Showcase-Portale)
Globale Strategie funktioniert nur, wenn sie die Küche übersteht: Einschränkungen, Kadenz, Klarheit und messbarer Output. So verwandelt ein Enterprise Media OS Marktrauschen in wiederholbare Systeme — mit figure.rocks und loving.rocks als Showcase-Implementierungen.
SEO Mobile Webapplikation München
SEO für Mobile Webapplikationen in München: saubere Indexierung, Analytics, strukturierte Sitemaps und Google-News-Optimierung als solides Fundament für nachhaltige Sichtbarkeit.
Webpräsenz mit Ansage - Automobile Bauer Joomla
Unternehmensfähige Produktionsplattform
Enterprise-grade CMS- und Portal-Plattform mit Multi-Database-Architektur, echter Mehrsprachigkeit und professioneller WordPress-Migration. Entwickelt für skalierbare, sichere und zukunftsfähige Publishing-Systeme.
Digitalisierungsportal für Archiv Museum Bibliothek
Das Deutsche Museum Digital widmet sich der Digitalisierung und wissenschaftlichen Erschließung der Bestände der Objektsammlung, des Archivs sowie der Bibliothek des Deutschen Museums.
Source of Truth Enterprise Intelligence Platform
Eine selbst gehostete, evidenzbasierte Unternehmensintelligenzplattform, die internes Unternehmenswissen, Dokumente und Geschäftsdaten in nachverfolgbare Intelligenz für Recherche, Entscheidungen, Monitoring und kontrollierte KI-Ausführung umwandelt.
Vom globalen Business bis in die Küche — Ein umgekehrtes Kommunikationssystem, das immer noch skaliert
Hör auf, nach Rauschen zu skalieren. Beginne mit globalen Signalen, reduziere sie auf einige wenige stabile Wahrheiten und verwandle sie in wöchentliche Vorlagen, Checklisten und wiederholbare „Menüs“, die echten Mehrwert liefern.
Mobile App-Erstellung mit Apache Cordova: Plattformübergreifende Fallstudie
Entdecken Sie, wie Apache Cordova Web-Apps in plattformübergreifende mobile Lösungen für Android, iOS und mehr verwandelt, mit detailliertem Prozess, Technologie-Stack und Vorteilen.
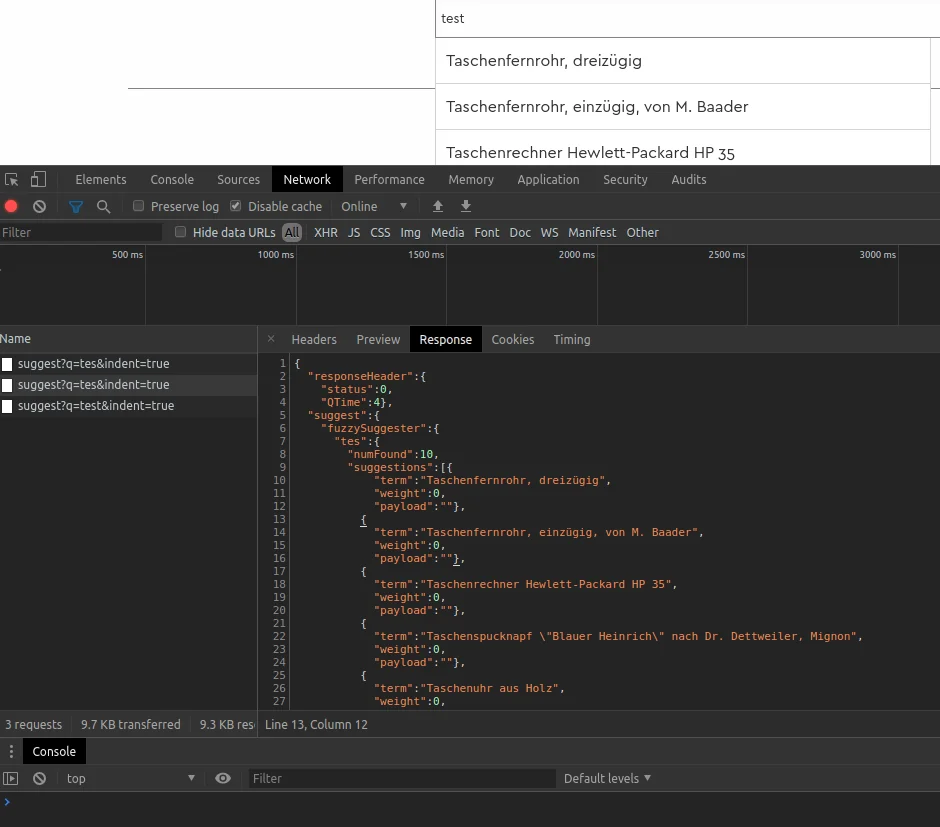
Solr Fuzzy Suggester und Solr Infix Suggester über Ajax
LibreOffice ChatGPT Makro-Integration Fallstudie
Entdecken Sie die benutzerdefinierte Python OpenAI Makro-Integration für ChatGPT in LibreOffice, die Arbeitsabläufe mit KI-Unterstützung direkt in Ihren Dokumenten verbessert.
Presence Platforms — Unternehmenskommunikation, die gewinnt, ohne zu konkurrieren.
Eine Presence-Plattform verwandelt operative Abläufe in Klarheit auf Entscheidungsebene: gesteuerte Aussagen, wiederholbare Formate, interne Verlinkungen, die Entscheidungen leiten, und eine wöchentliche Lernschleife, die Vertrauen und Pipeline steigert.