
证据能否在人工智能流水线中存续?——证据保全链
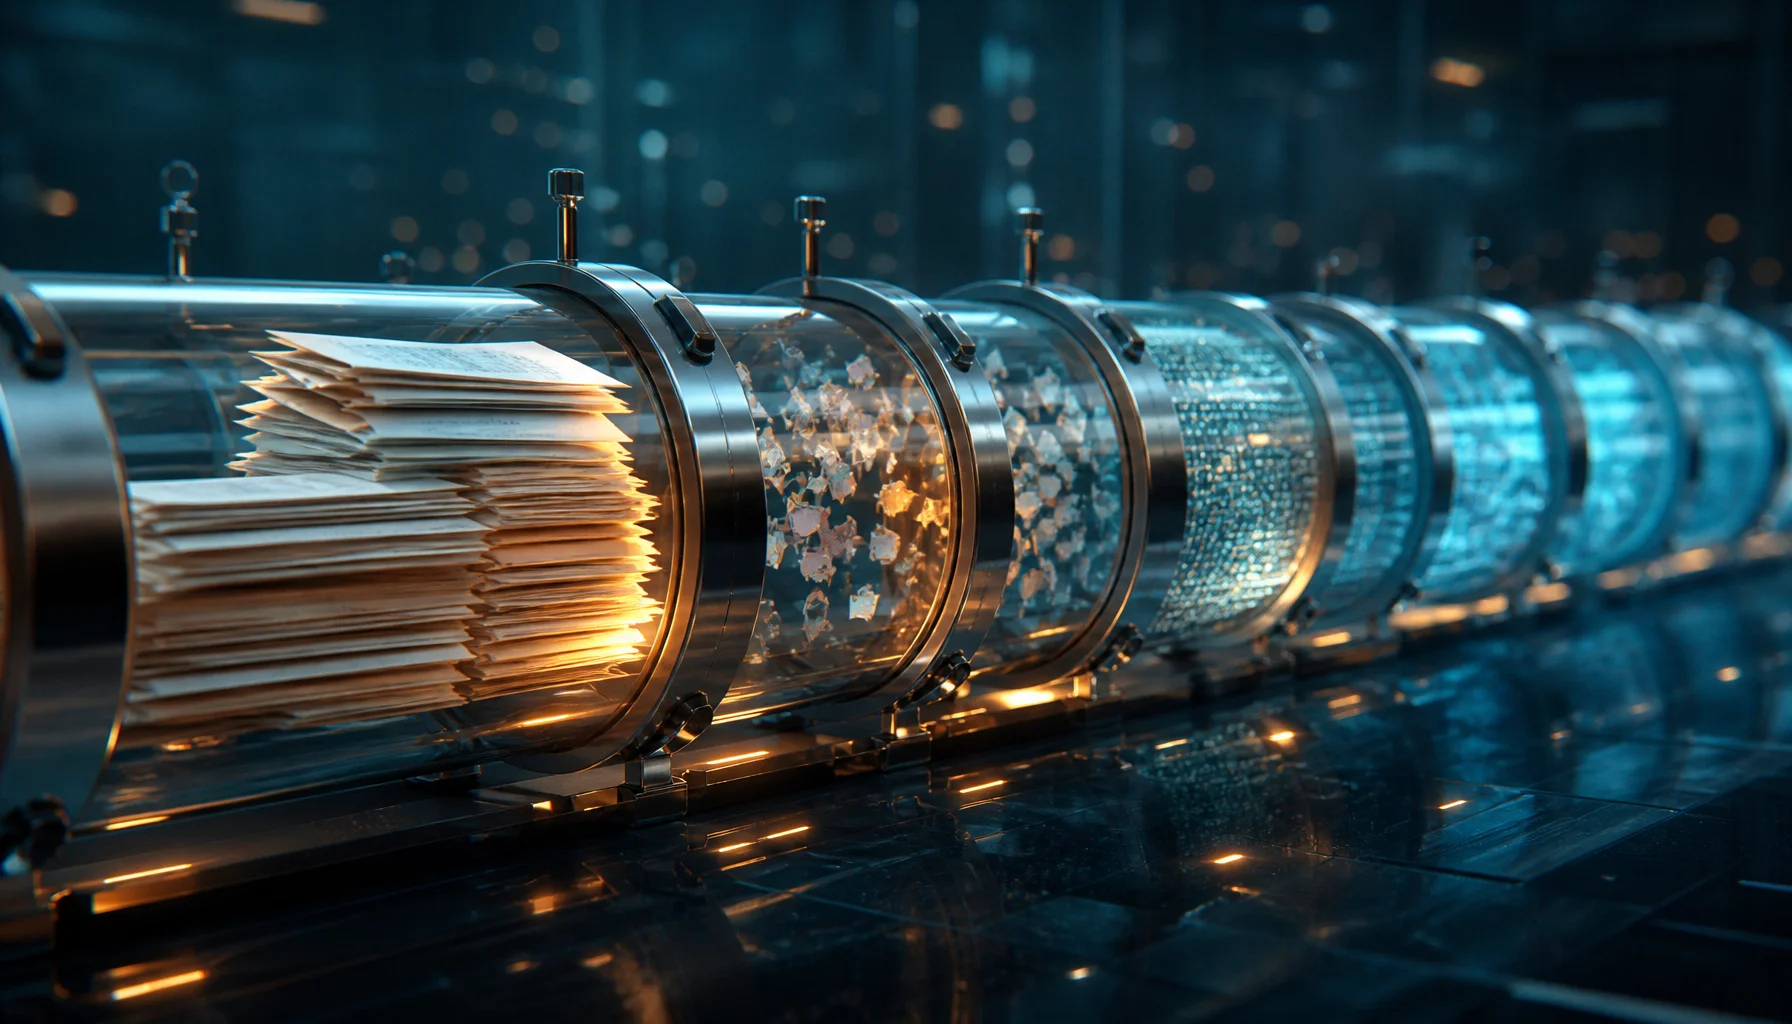
问题
当原始来源是正确的,但AI流程剥离了正确理解该来源所需的信息时,会发生什么?
如果解析移除了表格结构,分块将条件与其例外分开,归一化丢弃了单位,检索丢失了版本元数据,或者上下文组装隐藏了冲突,那么一份可靠的文档可能会变成不可靠的上下文。
本文使用术语“证据保存链”来指代这一要求:证据在从来源移动到最终AI上下文的过程中,必须保留正确解释所需的属性。
证据保存链是端到端的转换序列,证据必须通过该序列保留身份、来源、范围、含义和有效性,然后才能安全地支持AI生成的声明。— 工作定义——此处引入的架构概念,并非标准化研究术语。
这真正意味着什么
大多数关于RAG的讨论都集中在能否找到相关信息上。
但证据在模型看到它之前,通常要经过多次转换。
Original Source
   ↓
Parsing
   ↓
Normalization
   ↓
Chunking
   ↓
Indexing
   ↓
Retrieval
   ↓
Reranking
   ↓
Context Assembly
   ↓
Model
   ↓
Claim
即使原始文档完全正确,证据也可能在该链条的任何一点发生退化。
最简单的例子
假设一份产品手册包含以下陈述:
最高工作温度:40 °C,但安装附件X时除外,此时限值为35 °C。— 示例来源陈述
糟糕的分块过程将句子拆开。
Chunk A:
Maximum operating temperature: 40 °C.

Chunk B:
Except when accessory X is installed, in which case the limit is 35 °C.
检索器只返回块A。
检索到的文本并非捏造。它直接来自手册。然而,上下文恰恰在关键之处是不完整的。
Correct source
        +
lossy transformation
        =
misleading evidence
示例失效之处
证据保全并不意味着将每个源字节原封不动地复制到模型上下文中。
压缩、规范化、分块和摘要通常是必要的。目标是保留正确解释所需的属性,而不是消除转换。
因此,困难的工程问题是:哪些属性在语义上具有承载作用?
直接回答
当源与模型之间的转换保留了足够的身份、来源、结构、单位、条件、冲突和有效性元数据,使检索到的信息在上下文中与在源处具有相同含义时,证据就能在AI流水线中存活下来。
Evidence Preservation
=
meaning
+ identity
+ provenance
+ scope
+ units
+ conditions
+ validity
+ traceability
为什么即使源正确,RAG也可能失败
检索器可以找到正确的文档,但仍然提供错误的证据单元。
问题可能更早出现:在OCR、文档解析、HTML提取、表格转换、字段映射、分块构建或元数据丢失期间。
LLM从哪里获取数据?Python中的RAG数据源RAG始于外部数据源和检索方法。证据保全关注的是在原始源和检索到的上下文之间必须保留什么。
八个保全点
1. 身份
流水线必须保留证据实际描述的实体、产品、文档、用户、合同或记录。
2. 来源
系统应能够将检索到的证据追溯到其原始来源,而不仅仅是追溯到匿名的块标识符。
3. 结构
表格、标题、列表、父子关系和例外情况可能承载着当一切被扁平化为独立文本片段时就会消失的含义。
4. 单位
一个没有单位的数字可能变得无用或危险。100 可能意味着毫秒、千克、欧元、伏特或基线的百分比。
5. 条件和例外
规则通常包含适用条件。将规则与例外分开可能保留文字却破坏含义。
6. 版本和时间
证据应保留其何时生效、何时被观察到以及是否有更新的对象取代它。
7. 冲突状态
如果两个来源不一致,规范化不应静默地选择一个值并抹去存在分歧这一事实。
8. 访问范围
权限和租户边界必须在整个检索和上下文组装过程中始终附着于证据。
从原始数据到受控证据
保留证据最有力的位置通常是在向量化之前。
如果在创建嵌入之前就丢失了来源身份、有效性和冲突,检索无法在之后神奇地重建它们。
从原始数据到可验证的 AI 上下文:面向智能体就绪信息的实用架构该架构在检索之前就开始,通过在可复用信息对象中保留身份、来源、冲突、未知项和有效性。
上下文工程是链条的一部分
即使正确检索到的证据也可能在上下文组装过程中被破坏。
上下文构建器可能截断例外、移除来源标签、合并冲突段落、重新排序依赖关系或超出模型的有效注意力预算。
什么是上下文工程?模型在回答前接收到的内容上下文工程决定了哪些检索到的信息实际到达模型,以及在何种结构、有效性和安全约束下到达。
与证据距离的关联
证据保留和证据距离描述了不同的失效模式。
Evidence Preservation Chain:
Did the evidence survive transformation?

Evidence Distance:
How far is the final claim from that evidence?
一个系统可以完美地保留证据,但仍然从中做出无支持的推断。反之,最终推理可能很简单,而证据本身在流程的早期就已经被破坏了。
与检索权威层的关联
检索权威层选择哪个来源值得作为证据权重。
证据保留链确保使该来源具有权威性的属性在选择后不会被丢弃。
Authority at source
        ↓
Preservation through pipeline
        ↓
Authority still visible in context
实用数据模型
一个检索单元可以携带的不仅仅是文本。
{
  "text": "Maximum operating temperature is 40 °C...",
  "sourceId": "manual-v4.2",
  "entityId": "device-184",
  "section": "Operating limits",
  "validFrom": "2026-03-01",
  "unit": "°C",
  "conditions": ["35 °C when accessory X is installed"],
  "authority": "manufacturer_manual",
  "conflicts": [],
  "accessScope": "public"
}
确切的模式取决于应用。架构原则是,可检索的文本不应与解释它所需的元数据分离。
诊断/决策方法
选择一个重要的答案,并追溯一个支持性主张在系统中的反向路径。
- 识别最终主张。
- 识别支持它的确切上下文段落。
- 识别产生该段落的检索块。
- 识别该块背后的规范化记录或解析文档。
- 识别原始来源。
- 在每次转换中比较含义、范围、单位、条件和版本。
任何关键含义消失的点都是证据保留链中的断裂。
失效模式:孤立块
孤立块包含看似有用的文本,但与它来源的文档结构、来源身份、版本或适用条件没有可靠的关系。
"Refunds are available for 30 days."

Missing:
Which product?
Which country?
Which policy version?
From what effective date?
What exceptions?
该句子可能是真实的,但仍然是不安全的证据。
失败模式:通过发明进行规范化
规范化应该对齐表示。它不应静默地发明缺失值以使记录看起来完整。
Unknown
≠
False
≠
Zero
≠
Default
保留未知信息是保留证据的一部分。
失败模式:冲突坍缩
假设一个已批准的来源说24个月,另一个说36个月。
一个仅存储最后导入值的管道会产生干净的数据库,并破坏存在冲突的证据。
一个可验证的系统应保留两个值、它们的来源以及未解决的冲突,直到规则或人工决定解决它。
失败模式:上下文压缩
上下文压缩可能有用,但删除限定词的摘要可能会增加表面确定性。
Source:
"Evidence suggests X under conditions A and B, but the sample is small."

Bad compression:
"X is proven."
信息变得更短,同时更不真实。
边缘情况:有损压缩仍然可以是正确的
并非每一次损失都是有害的。
从段落中移除视觉格式可能没有语义后果。如果转换是明确且正确的,将摄氏度转换为开尔文可以保留含义。对完全相同的副本进行去重可以提高检索效率而不丢失证据。
因此,目标并不是在每个阶段都进行无损存储。而是语义上充分的保留。
局限性
证据保存链是一个架构框架,并不保证被保存的证据会被正确解读。
模型可以接收到完美保存的证据,但仍然推理得很糟糕。检索器可以保留来源信息,但仍然将错误的来源排在前面。来源本身也可能是错误的。
保存保护的是证据流水线。它不能替代来源评估或推理。
什么会改变这个答案?
未来的系统可能会检索结构化的证据对象,而不是文本块,自动保留来源图,并直接将机器可读的有效性约束暴露给模型和代理。
这将使证据保存更容易实现,但会使这一原则变得更加重要,而不是更不重要。
结论
可靠的人工智能需要的不仅仅是找到一个正确的来源。
使来源有用的属性必须在解析、规范化、分块、检索和上下文组装过程中得以保留。
Source Authority
      ↓
Evidence Preservation Chain
      ↓
Retrievable Evidence
      ↓
Evidence Distance
      ↓
Reasoning
      ↓
Answer Validity Boundary
如果链条断裂,模型可能会接收到技术上真实但不再能安全地解释为原始证据的信息。
主要来源
Patrick Lewis 等人,Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks(2020年)。
Nelson F. Liu 等人,Lost in the Middle: How Language Models Use Long Contexts(2023年)。
W3C,PROV Overview。
Related Articles

气隙AI:AI系统如何在没有互联网或云访问的情况下工作
气隙AI在隔离的安全域内运行模型、RAG和AI应用,无需互联网或云依赖。了解模型、数据、更新和工具如何离线运行。
AI主张与证据之间有多远?——证据距离
并非所有被支持的答案都与其证据同样接近。证据距离是一种实用的方式,用来描述一个AI主张与可直接检验的证据之间相隔了多少次转换、摘要、假设和推理步骤。

生成式人工智能解析:模型、检索、工具与应用并非同一回事
生成式AI不仅仅是一个模型。了解模型、检索、工具、上下文、运行时和应用程序如何在生产AI系统中协同工作。

企业级多租户架构,适用于国际平台
Loving Rocks 是一款企业级婚礼平台,采用真正的多租户架构设计,实现租户间数据库隔离,并内置国际化支持,以确保全球可扩展性、安全性及长期运营稳定性。

主权人工智能:模型、数据、基础设施与依赖关系的控制
主权人工智能关乎对模型、数据、基础设施、软件、运营和战略依赖的有效控制——而不仅仅是人工智能模型托管在哪里。
ADR 与 NFR:架构决策与系统质量并非同一回事
ADR 与 NFR 解析:了解系统质量需求如何驱动架构决策、ADR 如何记录权衡取舍,以及为什么验证保持独立。

MCP 解析:它连接什么、不做什么以及它适用于何处
模型上下文协议通过标准的客户端-服务器边界,将AI应用程序连接到外部工具、资源和提示。了解MCP能做什么、不能做什么,以及它在智能体架构中的定位。
AI治理:模型、数据、权限、风险与可审计性
AI治理定义了在模型、提供商、数据、权限、风险、评估及整个生命周期中,谁可以批准、操作、更改和审计AI系统。