
De datos brutos a contexto de IA verificable: una arquitectura práctica para información lista para agentes
La mayoría de los proyectos de IA comienzan demasiado tarde en el proceso. Empiezan con un modelo, un prompt o una capa de recuperación y solo después descubren que los datos subyacentes son inconsistentes, duplicados, obsoletos, privados o imposibles de rastrear hasta una fuente confiable.
Una arquitectura más duradera comienza antes de la recuperación. La primera tarea es decidir qué es realmente un objeto de información, de dónde proviene, a qué identidad pertenece, si otra fuente lo contradice y bajo qué condiciones sigue siendo válido.
Qué significa esto realmente
El objetivo no es crear otra base de conocimiento llena de texto. El objetivo es crear información que siga siendo útil cuando el consumidor ya no sea un humano navegando por un sitio web, sino una aplicación o un agente de IA tomando una decisión.
De datos heterogéneos a contexto controlado
El ejemplo más simple
Imagina tres fuentes de datos que describen el mismo dispositivo. Un proveedor dice que tiene 32 GB de memoria, un PDF más antiguo dice 16 GB y el feed del fabricante dice 32 GB para la revisión de hardware 4. Un pipeline de enriquecimiento normal puede elegir un valor y sobrescribir los demás. Un pipeline verificable mantiene la discrepancia visible hasta que se resuelvan la identidad y la revisión.
El resultado no es simplemente memoria = 32 GB. Se acerca más a: valor 32 GB, fuente feed del fabricante, revisión 4, mercado UE, observado en un momento conocido, fuente más antigua en conflicto presente, estado actual verificado para la revisión resuelta.
Dónde deja de funcionar el ejemplo
Los datos empresariales reales rara vez son tan limpios. Los nombres de productos varían, faltan identificadores, los PDF usan terminología diferente, los campos cambian de significado entre mercados y los datos privados de un inquilino no deben filtrarse al contexto de otro. Por eso la normalización por sí sola no es suficiente.
Un objeto de información reutilizable
| Campo | Propósito |
|---|---|
| Identidad | ¿A qué entidad o versión pertenece esta afirmación? |
| Valor | ¿Qué se afirma realmente? |
| Fuente | ¿De dónde provino? |
| Estado | Fuente verificada, afirmación del comerciante, proporcionado por el usuario, derivado, inferencia, desconocido o en conflicto |
| Observado en | ¿Cuándo se vio? |
| Validez | ¿Dónde, cuándo y para qué versión se aplica? |
| Derechos | ¿Se puede almacenar, reutilizar o redistribuir esta fuente? |
| Inquilino | ¿Qué cliente o propietario de los datos puede usarlo? |
Por qué RAG no es el primer paso
La recuperación solo puede recuperar lo que se ha indexado. Si se indexan datos en conflicto, obsoletos o legalmente restringidos sin gobernanza, RAG puede hacer que la respuesta parezca mejor mientras hace que la decisión subyacente sea menos confiable.
Un orden más seguro es: control de derechos → clasificación de fuentes → resolución de identidad → extracción de afirmaciones → procedencia → detección de conflictos → almacén de evidencia → recuperación → razonamiento.
Listo para agentes no significa controlado por agentes
Un agente debe recibir contexto controlado, no autoridad sin restricciones. El modelo puede razonar sobre la información disponible, pero no se le debe permitir fabricar hechos faltantes del producto, relajar restricciones obligatorias, eludir reglas de derechos de fuente o convertir la incertidumbre en certeza.
Por qué esto importa más allá de un solo dominio
La misma arquitectura se aplica a productos técnicos, planificación de eventos, documentación de software, catálogos de proveedores, conocimiento interno y comercio. Las reglas del dominio cambian, pero el problema central permanece: identidad, procedencia, conflictos, validez y reutilización controlada.
¿Qué cambiaría esta arquitectura?
La arquitectura debería volverse más simple cuando el sistema de origen ya proporciona identificadores canónicos, versionado estricto y calidad de datos contractual. Debería volverse más estricta cuando las decisiones afectan productos regulados, seguridad, datos privados o resultados legalmente sensibles.
Conclusión
La unidad útil para los futuros sistemas de IA no es solo un documento o un fragmento de texto. Es un objeto de información verificable con identidad, procedencia, estado, conflictos y un límite de validez. Esa es la capa que permite a portales, sistemas empresariales y agentes reutilizar el mismo conocimiento sin pretender que los datos inciertos sean ciertos.
Related Projects
Plataforma de Inteligencia Empresarial de Fuente de Verdad
Una plataforma de inteligencia empresarial autohospedada y gobernada por evidencia que convierte el conocimiento interno de la empresa, los documentos y los datos de negocio en inteligencia trazable para la investigación, las decisiones, el monitoreo y la ejecución controlada de IA.
Raíces locales, alcance global — Sistemas de comunicación y medios para los negocios modernos
Ayudo a los negocios locales a presentarse como marcas globales: posicionamiento claro, contenido de alto rendimiento y una distribución que convierte la atención en leads.
Estudio de caso de integración de macros de LibreOffice ChatGPT
Explora la integración de macro personalizada de Python OpenAI para ChatGPT en LibreOffice, mejorando los flujos de trabajo con asistencia de IA directamente en tus documentos.
Creación de aplicaciones móviles con Apache Cordova: Estudio de caso multiplataforma
Explora cómo Apache Cordova transforma aplicaciones web en soluciones móviles multiplataforma para Android, iOS y más, con un proceso detallado, pila tecnológica y beneficios.
Solr Fuzzy Suggester y Solr Infix Suggester a través de Ajax
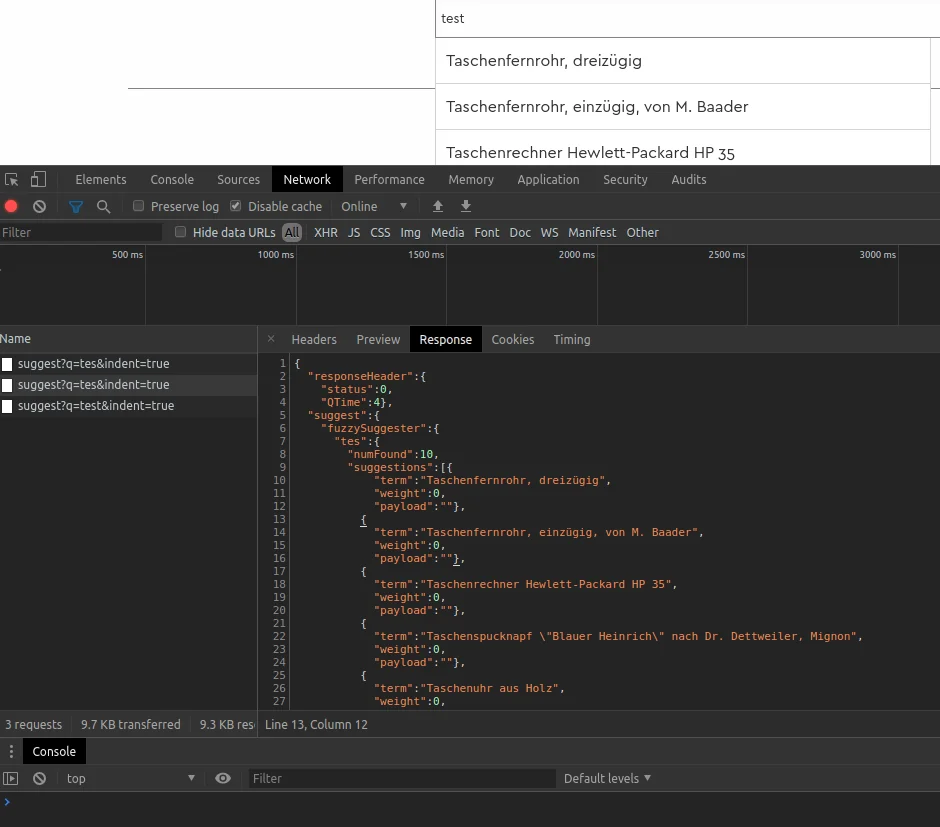
Para una búsqueda eficiente en el sitio web, es importante que los usuarios encuentren los resultados relevantes de forma rápida y sencilla. Solr Fuzzy Suggester y Solr Infix Suggester ofrecen una solución eficiente para esto. Se pueden invocar y filtrar a través de consultas Ajax.
Plataformas de Presencia — Comunicación empresarial que gana sin competir
Una Plataforma de Presencia convierte las operaciones en claridad de nivel de decisión: afirmaciones gobernadas, formatos repetibles, enlaces internos que enrutan decisiones y un bucle de aprendizaje semanal que potencia la confianza y el pipeline.
De la visión al valor: Maximizando el ROI del POS mediante la creación de una CI coherente y el branding estratégico
En el retail moderno, cerrar la brecha entre la visión creativa y el valor financiero requiere alinear la Identidad Corporativa (CI) con el Punto de Venta (POS). Este estudio de caso explora el marco de trabajo para eliminar la fricción cognitiva para mejorar el ROI.
Portal de digitalización para Archivo Museo Biblioteca
El Deutsche Museum Digital se dedica a la digitalización y apertura científica de los fondos de la colección de objetos, el archivo y la biblioteca del Deutsches Museum.
De los negocios globales a la cocina — SO de medios empresariales que escala con calma (stajic.de + Portales de showcase)
La estrategia global solo funciona si sobrevive a la cocina: restricciones, cadencia, claridad y resultados medibles. Así es como un Enterprise Media OS convierte el ruido del mercado en sistemas repetibles — con figure.rocks y loving.rocks como implementaciones de muestra.
SEO Aplicación web móvil Múnich
SEO para aplicaciones web móviles en Múnich: indexación limpia, analíticas, sitemaps estructurados y optimización para Google Noticias como una base sólida para una visibilidad sostenible.
De los negocios globales a la cocina — Un sistema de comunicación inversa que aún escala
Deja de escalar por el ruido. Empieza con señales globales, redúcelas a unas pocas verdades estables y conviértelas en plantillas semanales, listas de verificación y “menús” repetibles que entreguen valor real.
Plataforma de producción de nivel empresarial
Plataforma CMS y de portal de nivel empresarial con arquitectura multidatabase, verdadero multilingüismo y migración profesional de WordPress. Desarrollado para sistemas de publicación escalables, seguros y a prueba de futuro.