
La GPU non è il prodotto: architettura di IA privata a prova di futuro

La discussione sull'infrastruttura IA locale inizia spesso con la domanda sbagliata:
Quale GPU dovrei comprare?
Una domanda migliore è:
Quali tipi di carichi di lavoro di IA devo eseguire e dove dovrebbe essere eseguito ciascuno di essi?
Questa distinzione diventa sempre più importante man mano che l'infrastruttura IA si suddivide in diverse classi di hardware molto differenti tra loro. Una GPU consumer di fascia alta può offrire una velocità di inferenza eccezionale, ma una memoria relativamente limitata. Un sistema IA compatto può fornire molta più memoria con un consumo energetico inferiore, offrendo però una larghezza di banda di memoria decisamente inferiore. Le piattaforme edge aggiungono l'elaborazione dei sensori, flussi video in tempo reale e interfacce fisiche che le tradizionali workstation con GPU non sono mai state progettate per gestire.
Il risultato è che potrebbe non esistere più un unico computer IA ideale. Potrebbe invece esistere un tessuto di esecuzione IA ideale.
Hardware diversi risolvono problemi diversi
Consideriamo diverse classi di piattaforme NVIDIA attuali. Non sono semplicemente versioni più veloci o più lente della stessa macchina: rappresentano profili di capacità differenti.
La GeForce RTX 5090 è progettata attorno a una velocità di elaborazione e a una larghezza di banda di memoria estremamente elevate. Con 32 GB di memoria GDDR7 e una larghezza di banda molto elevata, è particolarmente adatta all'inferenza sensibile alla latenza quando il modello trova comodamente spazio nella memoria della GPU.
DGX Spark adotta un compromesso quasi opposto. Combina 128 GB di memoria unificata coerente con una larghezza di banda di memoria di 273 GB/s e un consumo energetico relativamente contenuto. Il suo principale vantaggio non è il throughput massimo di token, ma la capacità di mantenere residenti in memoria modelli e contesti notevolmente più grandi.
Anche Jetson AGX Thor offre un'architettura di memoria unificata capiente, ma il suo scopo è diverso. È progettato per l'IA fisica: flussi video da telecamere, audio, fusione di sensori, robotica e altri carichi di lavoro in cui l'IA deve interagire con l'ambiente fisico in tempo reale.
All'estremità professionale dello spettro, la RTX PRO 6000 Blackwell combina 96 GB di memoria GDDR7 ECC con una larghezza di banda di memoria estremamente elevata. Questa classe di acceleratori è particolarmente interessante per l'inferenza multi-tenant commerciale, poiché unisce una capacità di memoria molto più ampia a un throughput di livello workstation.
Latenza, capacità e IA fisica
Un utile modello di infrastruttura suddivide i carichi di lavoro in tre classi principali.
Inferenza orientata alla latenza
Conversazioni brevi, assistenza al codice, classificazione, estrazione, piccole query RAG e carichi di lavoro interattivi traggono vantaggio da un'elevata larghezza di banda della memoria e da una potente capacità di calcolo. Un sistema RTX di fascia alta è particolarmente adatto a questo ruolo.
Inferenza orientata alla capacità
Modelli di grandi dimensioni, contesti lunghi, ragionamento su documenti voluminosi, analisi batch e combinazioni di modelli richiedono spesso molta più memoria di quanta una GPU consumer tradizionale possa offrire. Sistemi come DGX Spark sacrificano la larghezza di banda pura a favore di un pool di memoria unificata molto più ampio.
IA fisica
Flussi di telecamere, pipeline audio, riconoscimento dei gesti, robotica e fusione di sensori richiedono funzionalità che vanno oltre il normale serving di LLM. Jetson Thor appartiene a questa categoria poiché il calcolo è integrato con interfacce progettate per sistemi che operano nel mondo fisico.
Il passo architetturale importante non consiste quindi nello scegliere tra queste piattaforme, bensì nel consentire loro di cooperare.
Il router IA diventa la vera piattaforma
Immagina che ogni applicazione invii richieste a un unico endpoint logico. Il client non ha bisogno di sapere se l'esecuzione avvenga su una workstation RTX, un nodo Spark, un sistema edge o un modello di frontiera esterno.
Uno strato di routing può valutare la lunghezza del contesto, la modalità, i requisiti di latenza, le policy sulla privacy, le capacità del modello, la priorità del tenant e l'attuale utilizzo dell'hardware prima di decidere dove eseguire una richiesta.
- Una breve richiesta di FAQ interna può essere indirizzata a un modello locale rapido su una GPU RTX.
- Una richiesta che coinvolge centinaia di documenti può essere instradata a un nodo Spark ricco di memoria.
- Un carico di lavoro legato a telecamere o sensori può essere inviato a Thor.
- Una richiesta di ragionamento particolarmente complessa può facoltativamente essere inoltrata a un modello cloud di frontiera, qualora la policy del tenant lo consenta.
L'infrastruttura smette quindi di essere incentrata sul modello e diventa incentrata sulle capacità.
Questa distinzione è importante perché i modelli cambiano molto più rapidamente rispetto all'architettura delle applicazioni aziendali. Un modello utilizzato oggi può essere sostituito l'anno prossimo senza modificare il contratto API utilizzato dal cliente. Lo stesso vale per l'hardware.
Una futura generazione di GPU può semplicemente essere introdotta come un ulteriore nodo di esecuzione, mentre la piattaforma circostante rimane invariata.
Il multi-model serving non equivale all'inferenza distribuita
Un presupposto comune è che un cluster IA debba trasferire costantemente enormi quantità di dati tra ciascun nodo. Questo vale solo per determinate architetture.
Se un singolo modello di grandissime dimensioni viene suddiviso su più macchine, la larghezza di banda tra i nodi diventa fondamentale perché i dati tensoriali devono muoversi continuamente tra i dispositivi.
DGX Spark include quindi una connettività di rete ConnectX-7 destinata alla comunicazione ad alta velocità del cluster, inclusa una connettività fino a 200 Gb/s per interfaccia supportata.
Documentazione sul clustering NVIDIA DGX Spark
Ma un servizio di IA privata non ha necessariamente bisogno di distribuire ogni modello. Può invece mantenere diversi modelli residenti su nodi differenti.
- Un nodo può ospitare il modello conversazionale rapido.
- Un altro può ospitare un modello di ragionamento di grandi dimensioni.
- Un terzo può eseguire embedding e reranking.
- Thor può elaborare carichi di lavoro in tempo reale per visione, audio e sensori.
In questa architettura, le richieste e le risposte attraversano la rete anziché i tensori interni del modello. Si tratta di multi-model serving, non di inferenza a modelli distribuiti.
Per molte implementazioni commerciali, questo approccio è più semplice, più economico e più facile da scalare.

Un cluster può servire molte aziende
La capacità dell'infrastruttura non può essere misurata semplicemente in base al numero di aziende clienti.
Venti aziende non generano necessariamente venti carichi di lavoro di inferenza simultanei. Un'azienda con trenta dipendenti potrebbe creare solo poche richieste contemporanee durante il normale orario di lavoro, mentre un singolo cliente fortemente orientato all'automazione potrebbe mantenere attivi decine di agenti continui.
Le metriche di capacità rilevanti sono quindi concorrenza, token al secondo, dimensione del contesto, richieste al minuto e priorità del servizio.
Ciò crea un'opportunità di multiplazione statistica: i clienti raramente consumano la loro capacità massima contrattualizzata contemporaneamente.
Un cluster eterogeneo può quindi servire molte organizzazioni più piccole, riservando al contempo capacità per i clienti con requisiti di latenza o disponibilità più rigorosi.
Il prodotto commerciale non è il tempo di calcolo della GPU
Competere direttamente con i fornitori di noleggio GPU su scala hyperscale è difficile. I loro modelli economici sono ottimizzati attorno all'utilizzo e alla scala dell'infrastruttura.
Un prodotto più difendibile è una piattaforma di IA privata gestita.
- Inferenza privata
- Retrieval-Augmented Generation (RAG)
- Isolamento dei tenant
- Controllo degli accessi basato sui ruoli (RBAC)
- Logging di audit
- Routing dei modelli
- Ingestione di documenti
- Connettori e API
- Valutazione e monitoraggio
- Capacità dedicata o riservata
Il cliente non paga principalmente per l'accesso a una GPU. Il cliente paga per un livello applicativo di IA controllato.
I modelli locali non hanno bisogno di superare l'IA di frontiera
Un altro errore architetturale consiste nel considerare i modelli open-weight come sostituti diretti dei sistemi frontier più potenti.
Non è necessario che lo siano.
Un'azienda che chiede: “Quale periodo di preavviso è definito in questo contratto?” non ha necessariamente bisogno del modello di ragionamento general-purpose più potente disponibile.
Richiede un'ingestione affidabile, un recupero corretto, un accesso basato sui permessi, la provenienza delle fonti e un modello sufficientemente capace.
Per un'ampia percentuale di carichi di lavoro aziendali, la qualità del livello applicativo circostante può contare tanto quanto l'LLM sottostante.
La piattaforma può quindi utilizzare modelli locali per i carichi di lavoro ad alto volume e sensibili alla privacy, riservando al contempo i modelli frontier per la percentuale relativamente ridotta di richieste che ne hanno realmente bisogno.
Ciò crea una forma di inferenza a cascata: modelli privati ed economici elaborano la maggior parte delle richieste, mentre le funzionalità più costose vengono richiamate solo quando necessario.
Essere a prova di futuro non significa prevenire l'obsolescenza
Nessun acceleratore AI è a prova di futuro in senso letterale. Il nuovo hardware diventerà sempre più veloce.
L'obiettivo ingegneristico utile consiste invece nel ridurre il rischio di obsolescenza tecnologica.
Una GPU che oggi rappresenta il dispositivo di inferenza principale può successivamente diventare un server di embedding, un worker per l'elaborazione batch, un nodo per la generazione di immagini o un pool di inferenza secondario.
Un sistema ad alta memoria che in precedenza ospitava il modello più grande disponibile può in seguito diventare un nodo dedicato per RAG, contesti lunghi o analisi batch.
Il nuovo hardware dovrebbe ampliare la piattaforma anziché invalidarla.
Ciò richiede di separare il livello di esecuzione dal livello applicativo.
Le risorse durature non sono le GPU in sé. Sono i contratti API, la logica di routing, il modello di tenancy, le regole di sicurezza, le pipeline documentali, l'architettura RAG, il sistema di valutazione, l'osservabilità e le integrazioni dei clienti.
L'hardware diventa un'infrastruttura sostituibile.
Il vero prodotto
L'architettura di AI privata più duratura assomiglia quindi meno a una workstation e più a un cloud in miniatura.
- Diversi pool di hardware forniscono diverse capacità.
- Uno strato di pianificazione (scheduling layer) decide a quale destinazione appartiene ciascun carico di lavoro.
- I modelli locali gestiscono le richieste private e ad alto volume.
- L'hardware per l'IA fisica gestisce sensori e ambienti in tempo reale.
- I servizi di frontiera rimangono disponibili come percorsi di escalation controllati.
- È possibile introdurre nuovi acceleratori senza costringere i clienti a modificare le proprie applicazioni.
Da questa prospettiva, la domanda centrale non è più:
Quale GPU dovrebbe alimentare il sistema?
Diventa invece:
La piattaforma può continuare a fornire lo stesso servizio quando la GPU, il modello o il fornitore cambiano?
Se la risposta è sì, l'infrastruttura ha ottenuto qualcosa di molto più prezioso del semplice possesso di hardware veloce.
Ha trasformato la potenza di calcolo in uno strato di esecuzione sostituibile.
Ed è lì che un sistema di IA privata inizia a diventare una piattaforma.
Related Articles
tensorflow
Trascinamento e rilascio con JavaScript: Una analisi approfondita dell'API nativa per strutture di menu interattivi
L'implementazione della funzionalità di trascinamento e rilascio (drag and drop) è fondamentale per le moderne interfacce utente interattive. Questo articolo esamina la sua implementazione tecnica utilizzando l'API nativa HTML5 Drag-and-Drop in Vanilla JavaScript e TypeScript, con un focus sulla creazione di strutture di menu dinamiche.
Architettura Canonica, Progettazione URL, Logica del Resolver, Specifiche API e Scalabilità
Architettura di scoperta geobasata per portali multi-tenant. Definisce URL canonici, logica di risoluzione, strategia di caching e un modello di lettura geografico senza accoppiamento con CMS o rifattorizzazione del database. Progettata per stabilità SEO, scalabilità ed estensioni future come prenotazioni e mappe.
Database Marketing: Un approccio moderno alle relazioni con i clienti
Database marketing è essenziale per la moderna gestione delle relazioni con i clienti. Scopri come l'uso strategico dei dati, l'esperienza tecnica e l'innovazione promuovono interazioni personalizzate con i clienti e una crescita sostenibile.
Enterprise: Inizia qui: La tua porta d'accesso all'eccellenza operativa
Nuovo sulla nostra piattaforma enterprise? Questa guida fornisce un percorso di onboarding strutturato, dai modelli di riferimento fondamentali a playbook, runbook e assessment operativi progettati per un'implementazione fluida.
Quectel RM500U-EA nel ZBT Z8102AX: bande 5G, o2 Germania e comportamento del segnale nel mondo reale
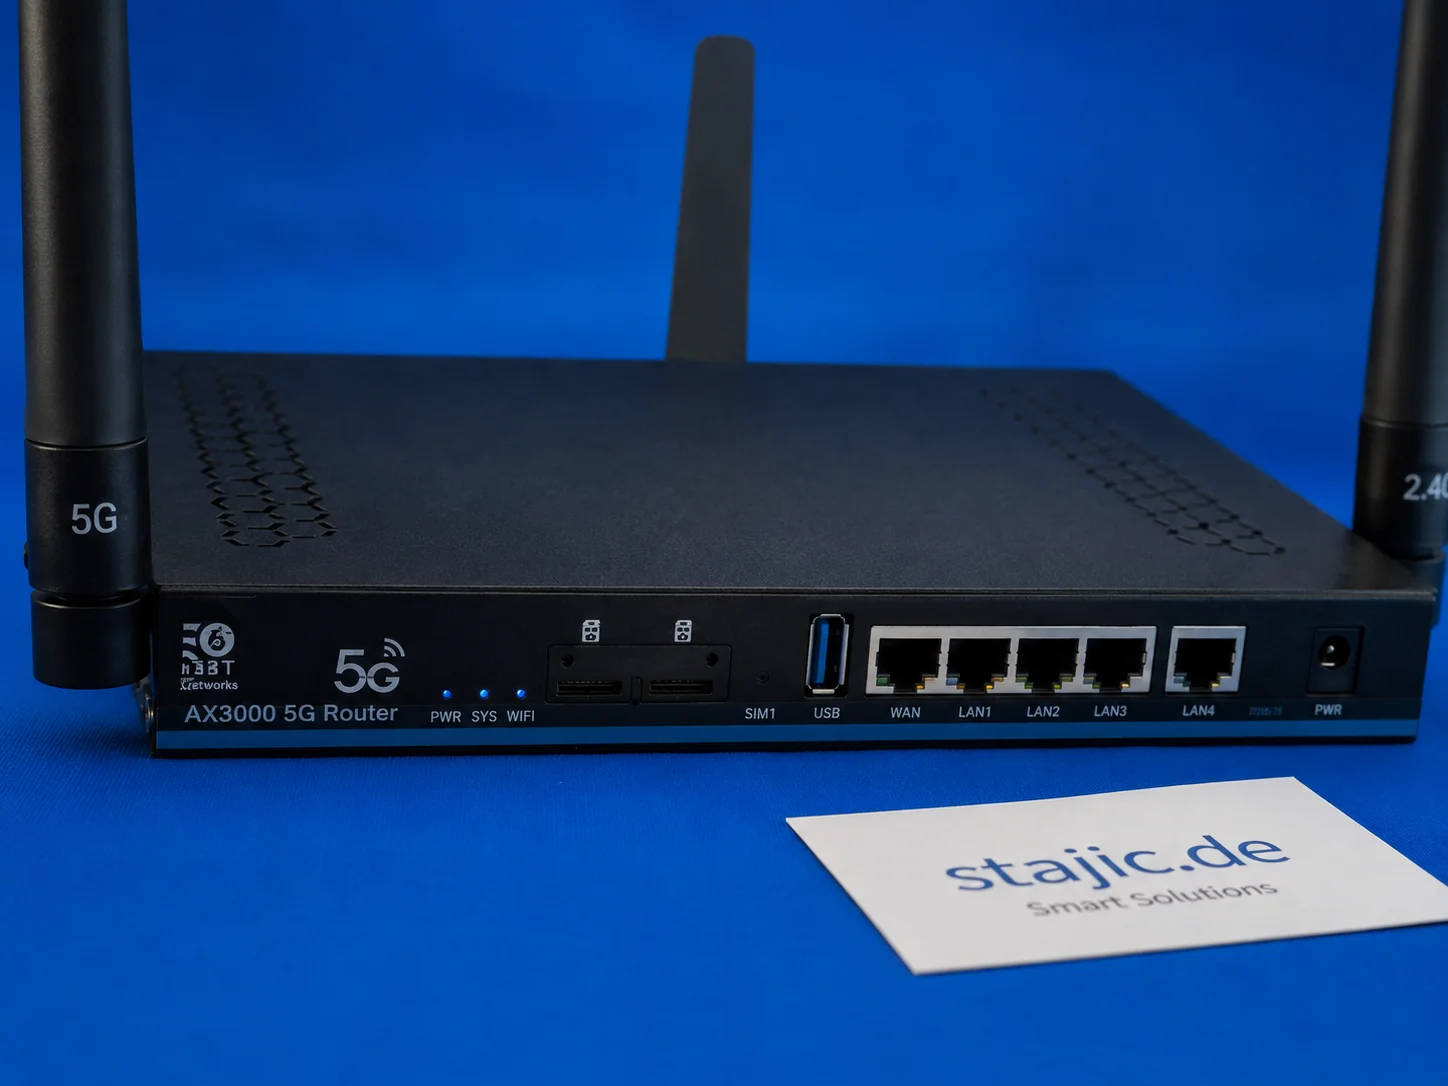
Lo ZBT Z8102AX utilizza un modem Quectel RM500U-EA per la connettività 4G e 5G. Nel primo test pratico, il router si è connesso con successo a o2 Germany con la banda LTE 3 e NR n28. Il modem funziona, ma diagnostiche più approfondite come RSRP, RSRQ, SINR, il blocco delle bande e il comportamento delle celle richiedono ancora test adeguati.
Sviluppo Front-end e Backend
Lo sviluppo front-end e back-end è una parte essenziale dello sviluppo web e comporta la creazione di applicazioni web e siti web. Lo sviluppo front-end si concentra sull'interfaccia utente, mentre lo sviluppo back-end è responsabile della programmazione e della gestione del lato server.

Affidabilità degli Agenti AI: Perché la Risposta Finale Non è Sufficiente
Un output corretto non dimostra un ragionamento corretto, un'esecuzione sicura o un sistema affidabile.
Rimuovi fonti di pacchetti APT duplicate: Guida per esperti per Ubuntu e Debian
Una guida dettagliata per l'identificazione e la rimozione di fonti ridondanti o duplicate di pacchetti APT in sistemi Debian e Ubuntu, per garantire stabilità e prestazioni.
entdecke-die-bahnbrechenden-moeglichkeiten-von-gpt-4
Il prompt fa parte del bias: come il framing dell'IA modella il ragionamento
La formulazione del prompt non è neutrale. Esplora come il framing, i presupposti, il rispetto delle istruzioni e la sicofanzia possano plasmare il ragionamento dell'IA—e perché conclusioni affidabili richiedano test che vadano oltre il prompt originale.
Google I/O 2026: Prodotti agentici su Search, Workspace e Shopping
Google I/O 2026 ha mostrato che l'IA agentica sta andando oltre le demo dei modelli e gli strumenti per sviluppatori, entrando nelle superfici dei prodotti di tutti i giorni. Questo articolo analizza come Ricerca, Workspace, Gemini Spark e Universal Cart puntino verso un nuovo modello di prodotto in cui gli agenti di Google aiutano gli utenti a fare ricerche, lavorare, fare acquisti e agire attraverso i servizi connessi.